同一个问题问两遍,答案为什么不一样?
本期包含本栏目实测与公开资料。实验条件、局限和资料来源见正文。
完整文字版与来源
它不是在查答案,是在抽签
很多人都有过这种体验:同一个问题,前后脚问两遍,AI 给的答案不一样,有时甚至互相矛盾。第一反应通常是:它是不是不靠谱?
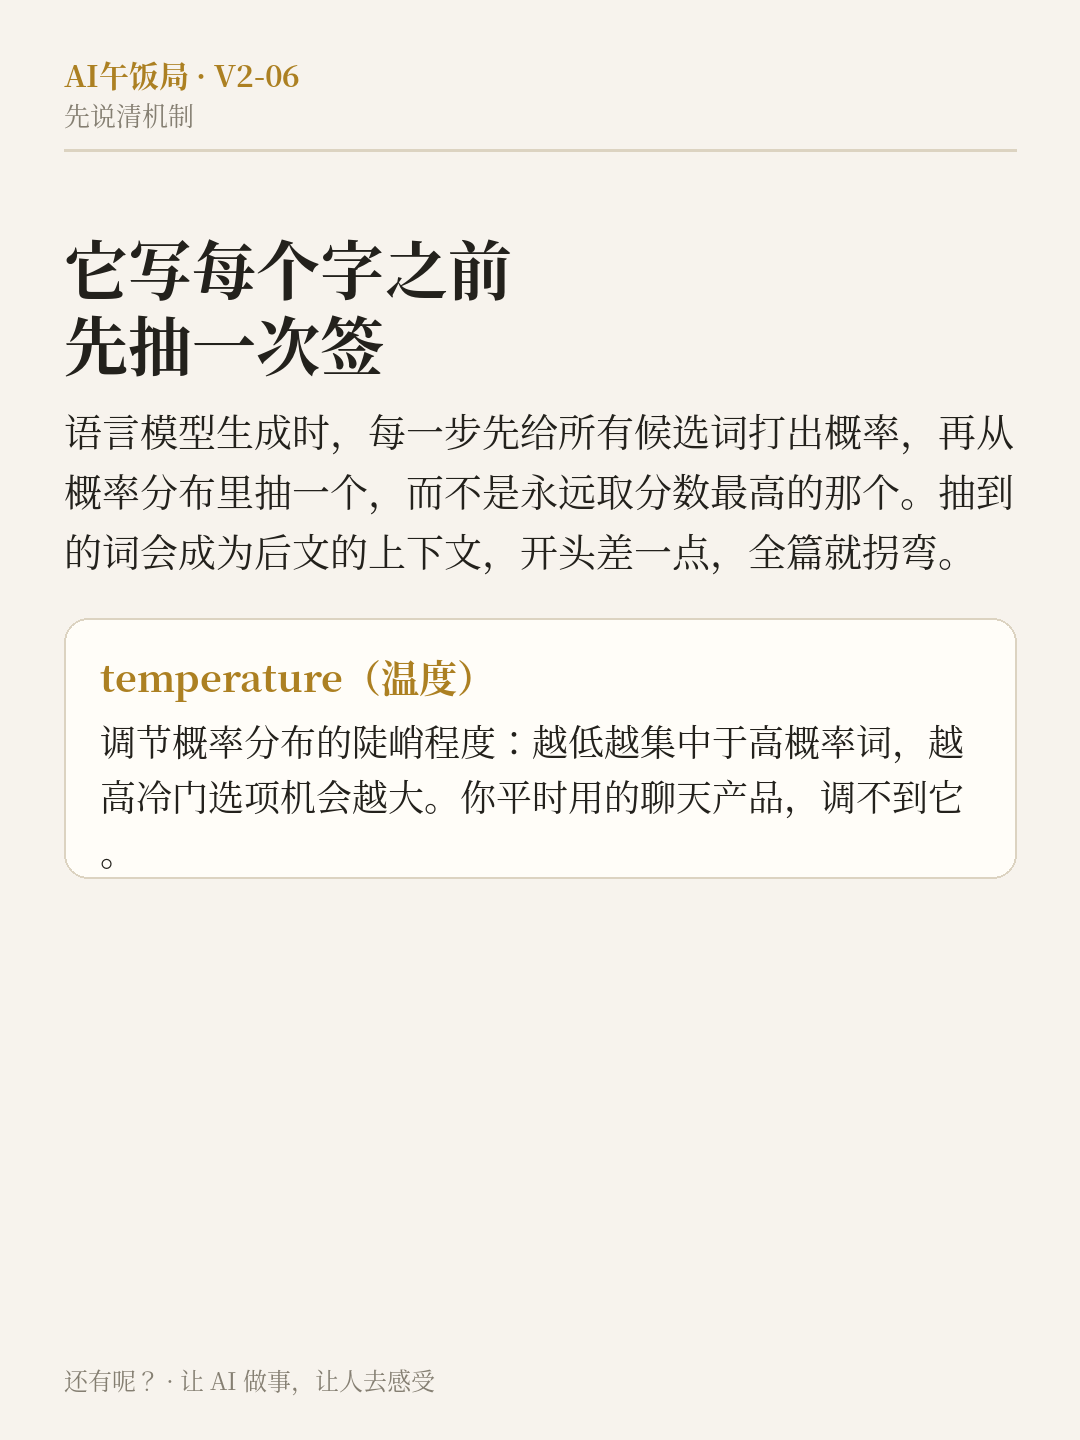
其实,不一样才是它的正常工作方式。语言模型写字的方法是:每写下一个词之前,先给所有可能的下一个词打分,形成一张概率表,再从这张表里抽一个出来,而不是永远挑分数最高的那个。抽到的词会成为后面的上下文,于是开头差一个字,整篇就可能拐向不同的方向。
打个比方:它不是在字典里查一条现成的答案,而是在一个装满纸条的箱子面前,每写一个字就伸手抽一张。箱子里的纸条不是一样多——越可能的词,纸条越多。那个叫 temperature(温度)的参数,管的就是箱子有多「平」:温度低,抽到冷门纸条的机会被压得很低;温度高,冷门选项的机会被放大。至于你平时用的聊天产品,温度是多少,你通常看不到,也调不了。
那么问题就变成了一个可以测量的事:抽签的幅度有多大?是不是所有问题问两遍都会不一样?
我们的实测:四道题,问了十二遍
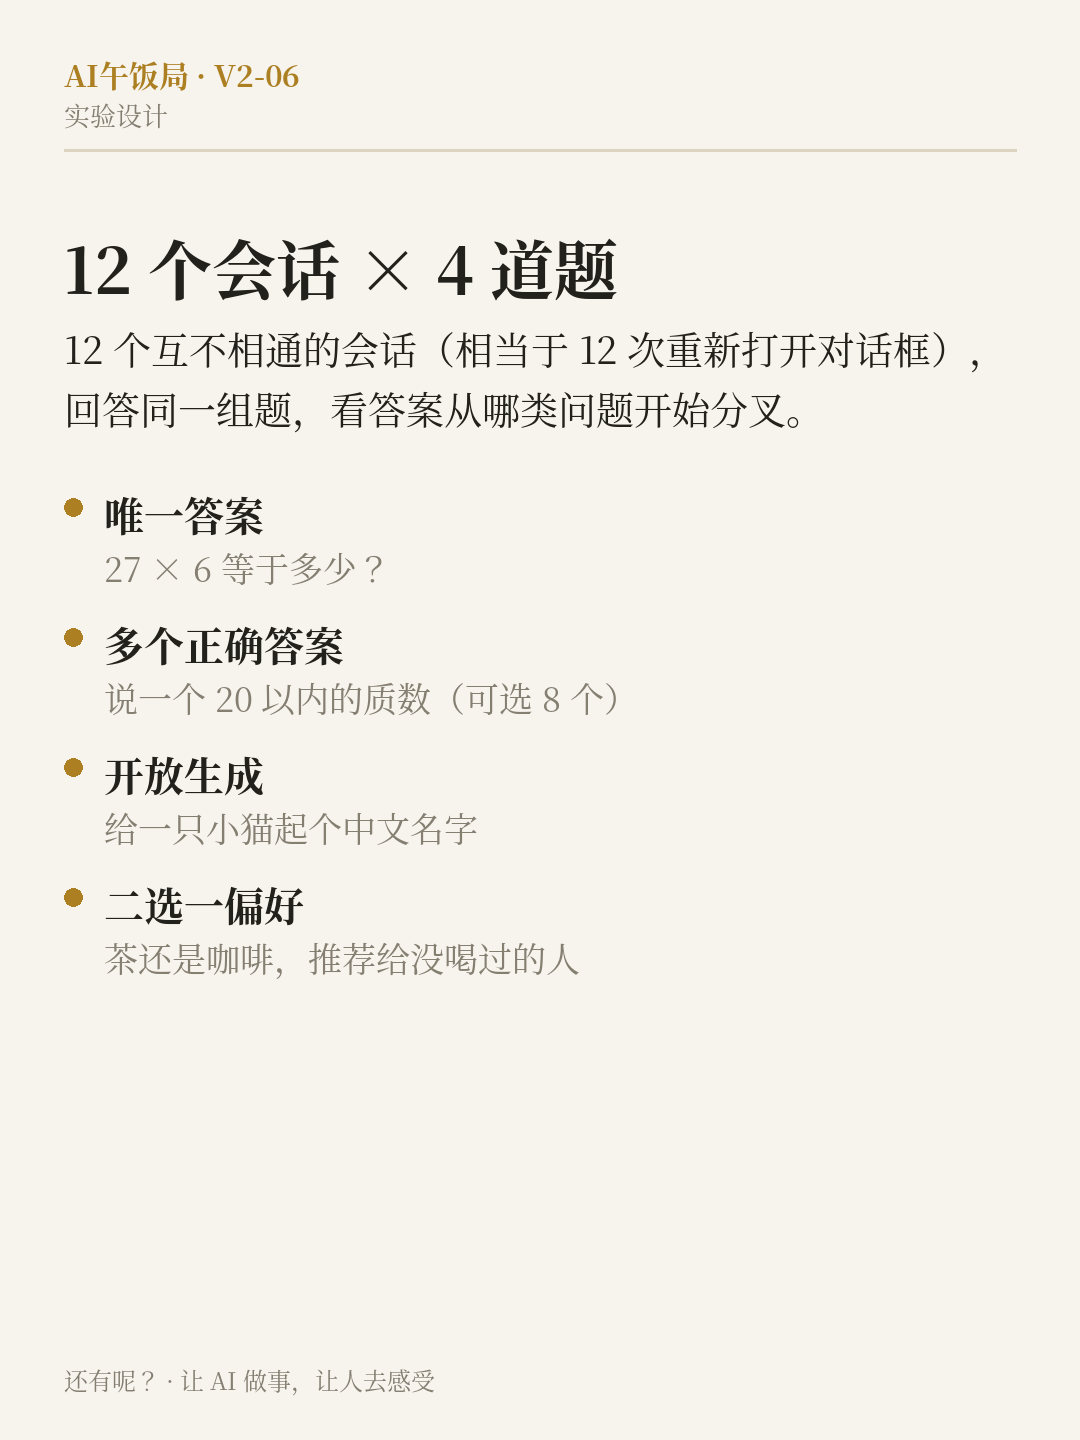
我们开了 12 个互不相通的会话(相当于 12 次「重新打开对话框」),每个会话回答同一组四道题:一道答案唯一的算术题,一道有多个正确答案的题,一道开放题,一道二选一偏好题。
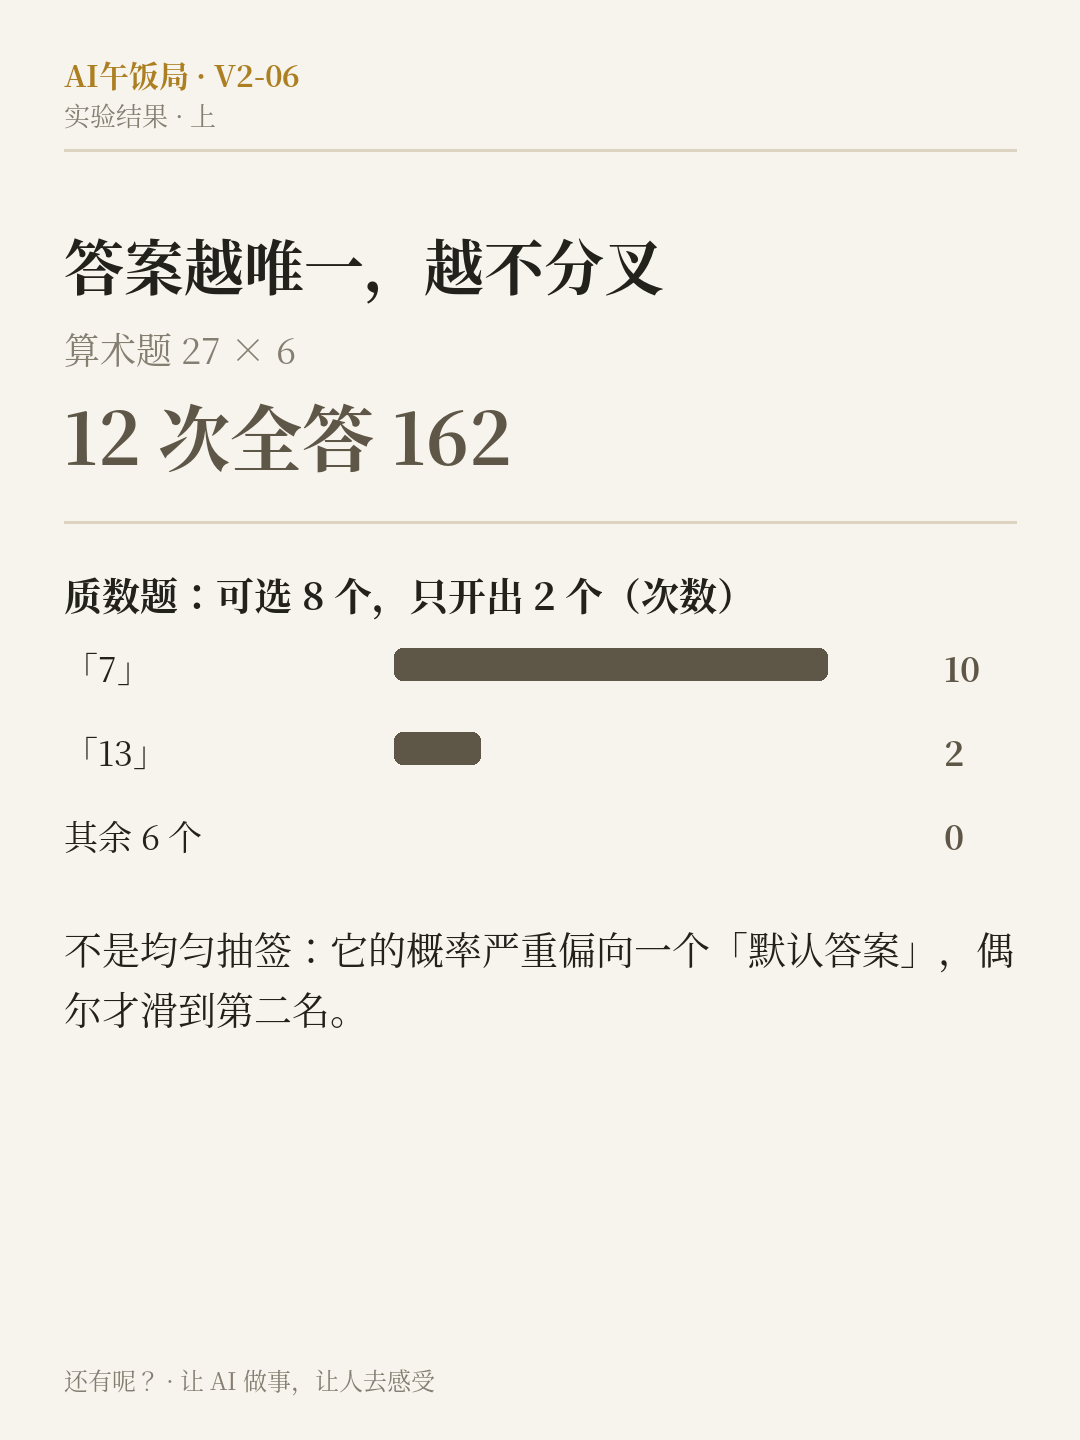
第一道:27 × 6 等于多少? 12 次,全部回答 162,一次都没差。答案唯一的题,概率几乎全压在一个词上,抽签抽不出第二种结果。
第二道:说一个 20 以内的质数。 可选的答案有 8 个:2、3、5、7、11、13、17、19。如果它真是在「均匀抽签」,12 次应该开出五六种才对。实际结果:只出现 2 种——「7」出现了 10 次,「13」出现了 2 次,其余 6 个质数一次都没被选中。抽的是加权签,而且权重悬殊:模型心里有一个压倒性的「默认答案」,偶尔才滑到第二名。
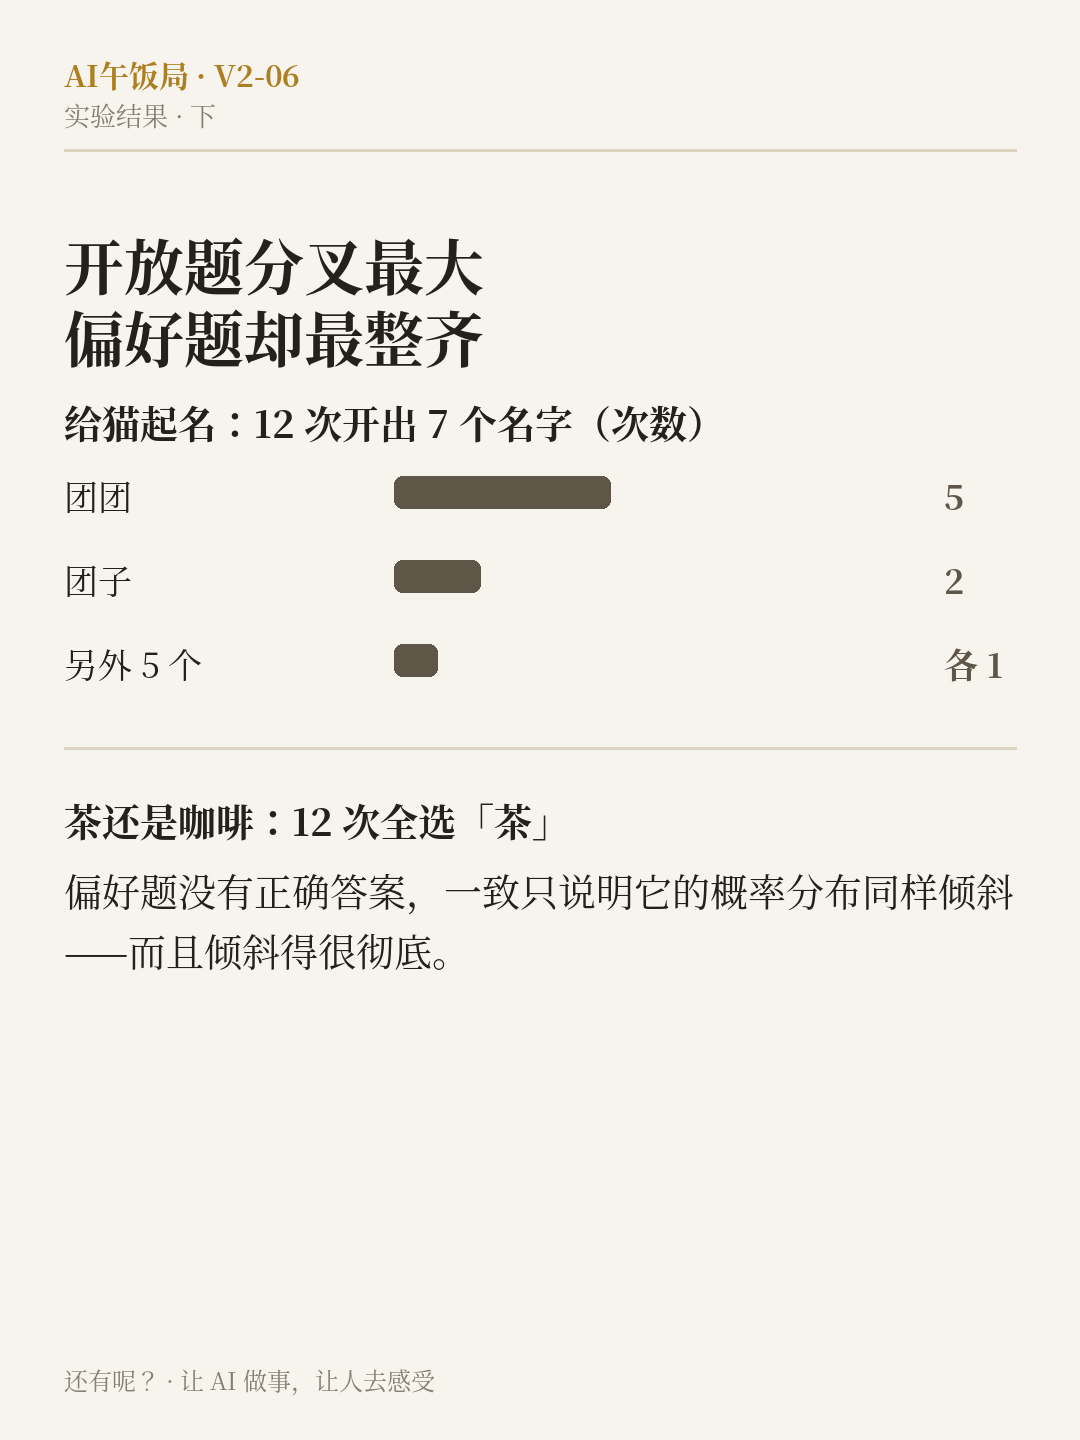
第三道:给一只小猫起个中文名字。 这是纯开放题,没有对错。12 次开出了 7 个不同的名字:团团(5 次)、团子(2 次)、糯米、小橘、小糯米、奶糖、年糕(各 1 次)。分叉最大的一道题,但依然不是天马行空——「团团」一个名字就占了近一半,它对猫名的审美有明显的众数。
第四道:茶和咖啡,推荐哪个给没喝过的人? 12 次全部选「茶」。这是个偏好题,没有正确答案,它的一致不能说明茶更正确,只能说明它的概率分布在这道题上同样倾斜——而且倾斜得非常彻底。
有意思的是:连「完全确定」也做不到
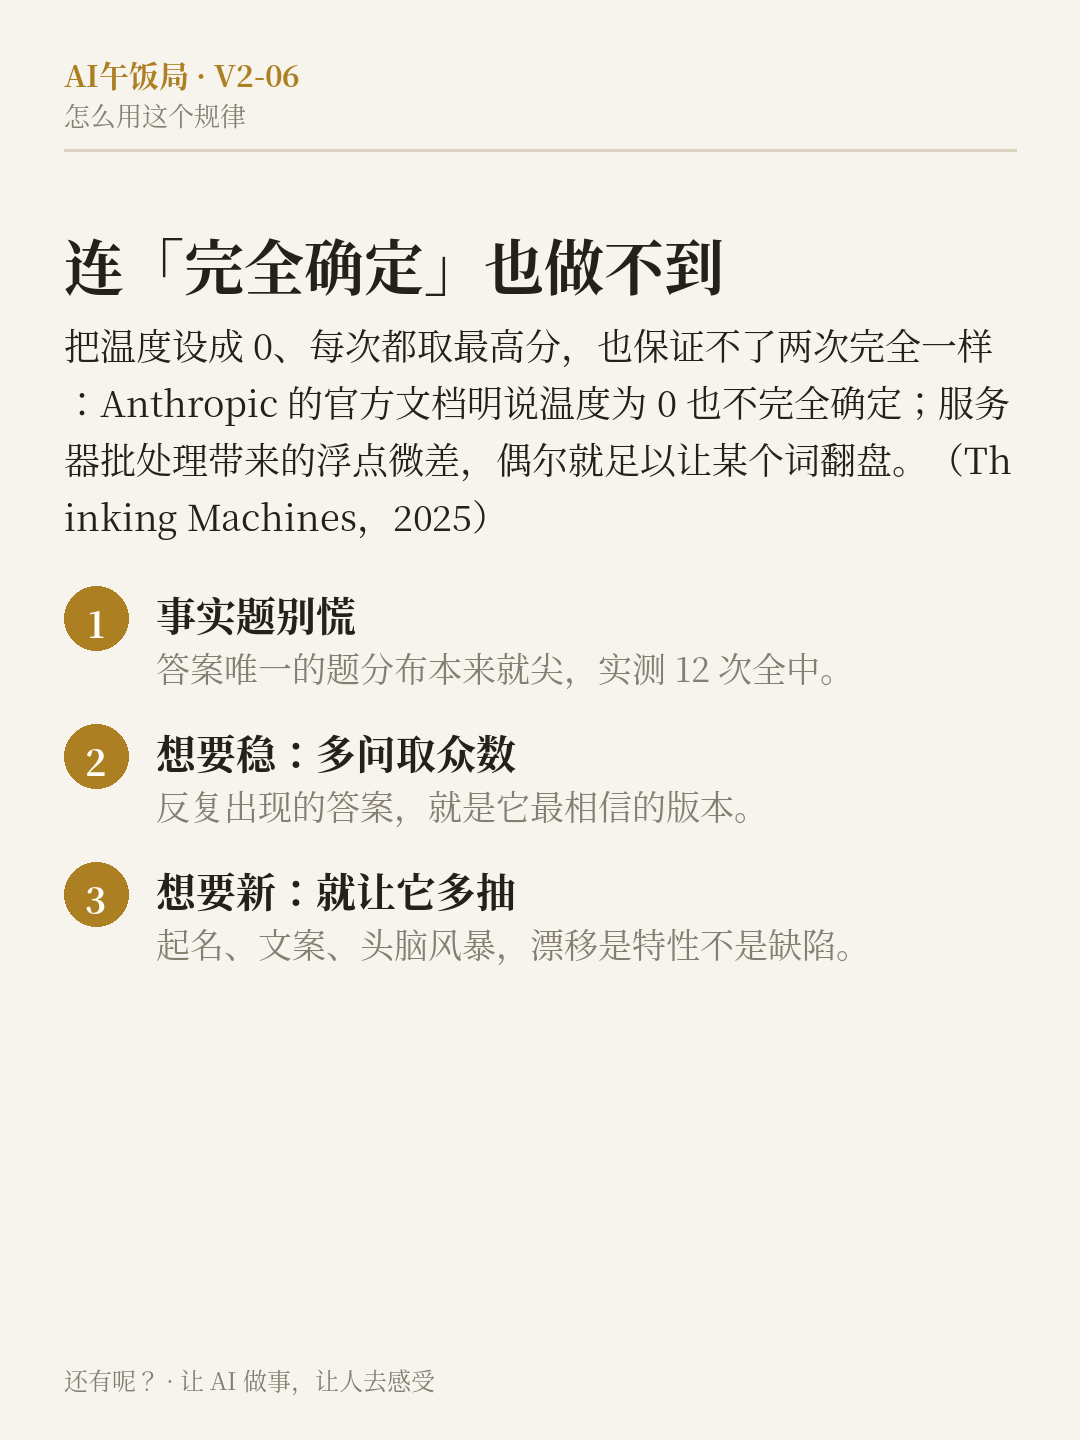
你可能听说过一个说法:把温度设成 0,每次都挑分数最高的词,输出就该分毫不差。现实里做不到。Anthropic 的官方文档直接写明:即使温度为 0.0,结果也不会完全确定。Thinking Machines 实验室 2025 年的分析找到了其中一个原因:你的请求在服务器上是和别人的请求打包一起算的,打包的规模随忙闲变化,浮点计算的细微差别随之变化——这些小到尘埃的差异,偶尔就足以让某个词翻盘。也就是说,不一致有一部分来自生成机制(抽签),还有一小部分来自机房本身,哪个用户都关不掉。
怎么用这个规律
知道了答案是抽出来的,有三件事就顺理成章:
事实类问题,它不一致多半不是灾难信号。 唯一答案的题(计算、定义、明确事实),分布本来就尖,实测里 12 次全中。真正会漂移的是多解和开放任务——那本来就不该期待唯一答案。
想要稳定,就利用抽签。 同一个问题多问几次,看哪个答案反复出现——反复出现的就是它的众数,是它「最相信」的版本。我们的质数题里,「7」十次对「13」两次,就是这个意思。让多个答案互相投票,是对付不确定性最土也最有效的一招。
想要新意,反过来做。 头脑风暴、起名、写文案时答案漂移是特性不是缺陷:同一道起名题问 12 次,能收 7 个名字回来挑。把「它怎么老变」换成「请它多变几版」,是同一件事的两种用法。
边界
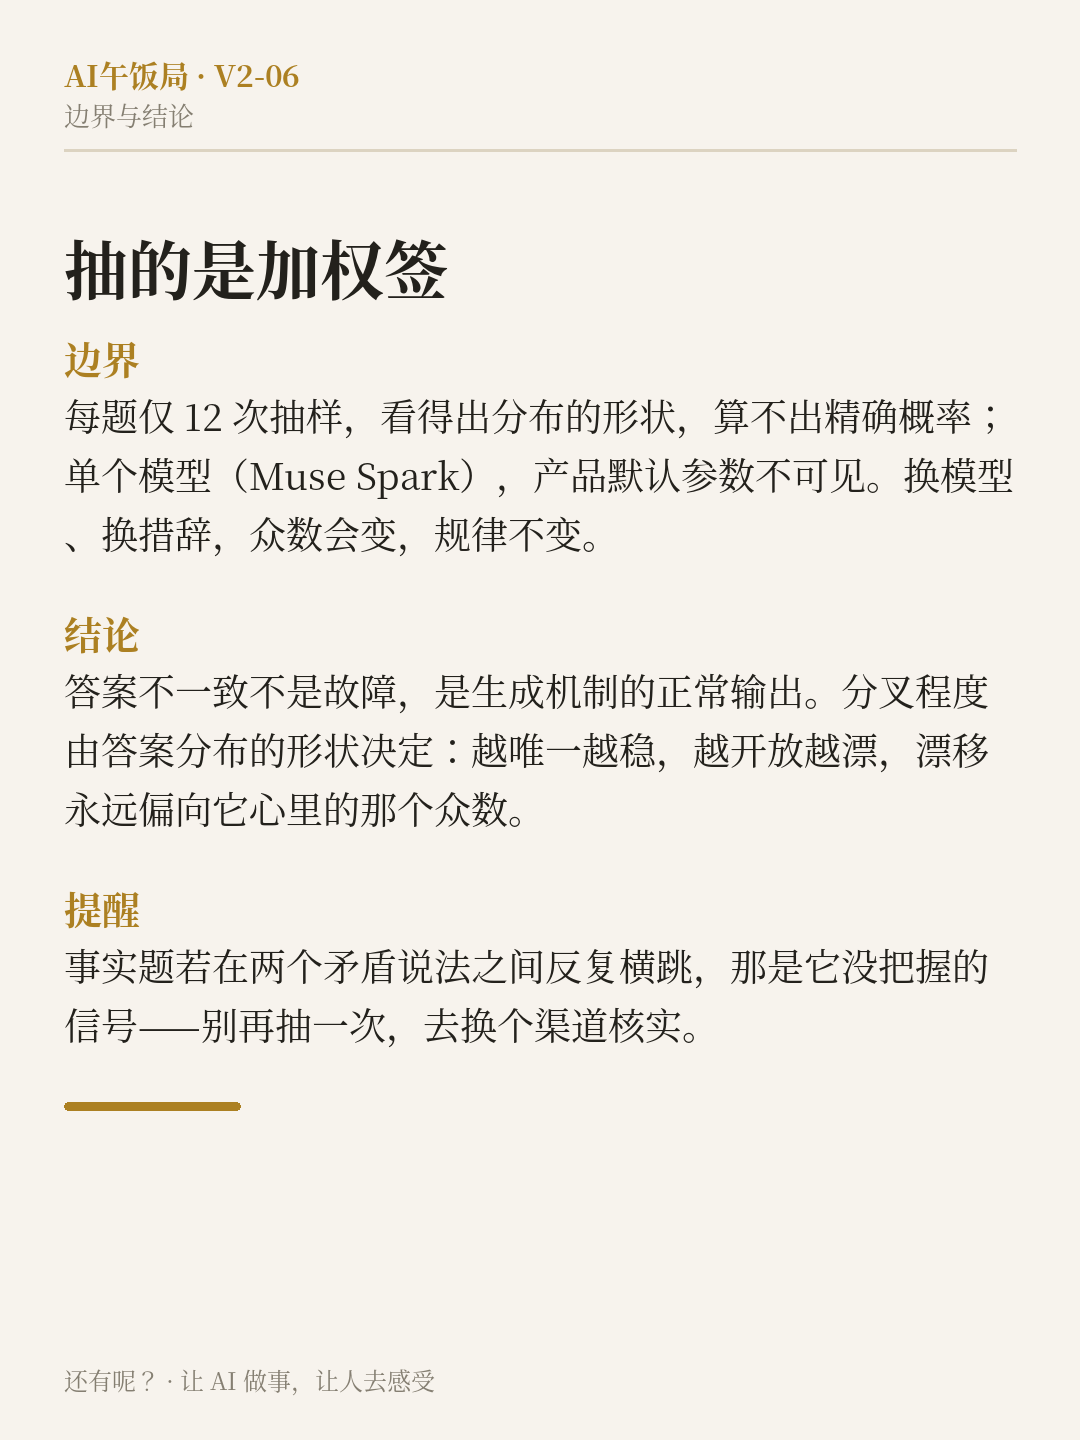
这次实测每道题只有 12 次抽样,能看出分布的形状(尖还是平、众数有多强),算不出精确概率;执行的是单个模型(Muse Spark),经智能体会话调用(产品默认参数不可见、温度不可调);换模型、换题面措辞,众数会变,但「分叉程度取决于答案分布的形状」这个规律应该普遍成立。
另外提醒一句:问两遍答案不一样,多数时候只是抽签;但如果一道事实题的答案在两个互相矛盾的说法之间反复横跳,那可能是它在那件事上本来就没把握——这时该做的不是再抽一次,而是换个渠道核实。
来源 机制:语言模型逐词采样、temperature 与 top-p 的作用(公开技术资料综述);Anthropic API 文档(温度为 0 亦不完全确定);Thinking Machines Lab 关于推理批处理与不确定性的分析(2025-09,经检索转述)。 实测:本栏目实测,12 个独立会话 × 4 道题(执行模型 Muse Spark,2026-11-04),原始记录与统计脚本见本期实验档案。