塞给 AI 十万字,它会漏读中间吗?
本期含 [本栏目实测] 内容,实验条件与局限随结论一并标注;文献数字为 [已核实事实] 并标注年代与出处;原因分析为 [编辑分析]。
完整文字版与来源
开场:一个流传很广的说法
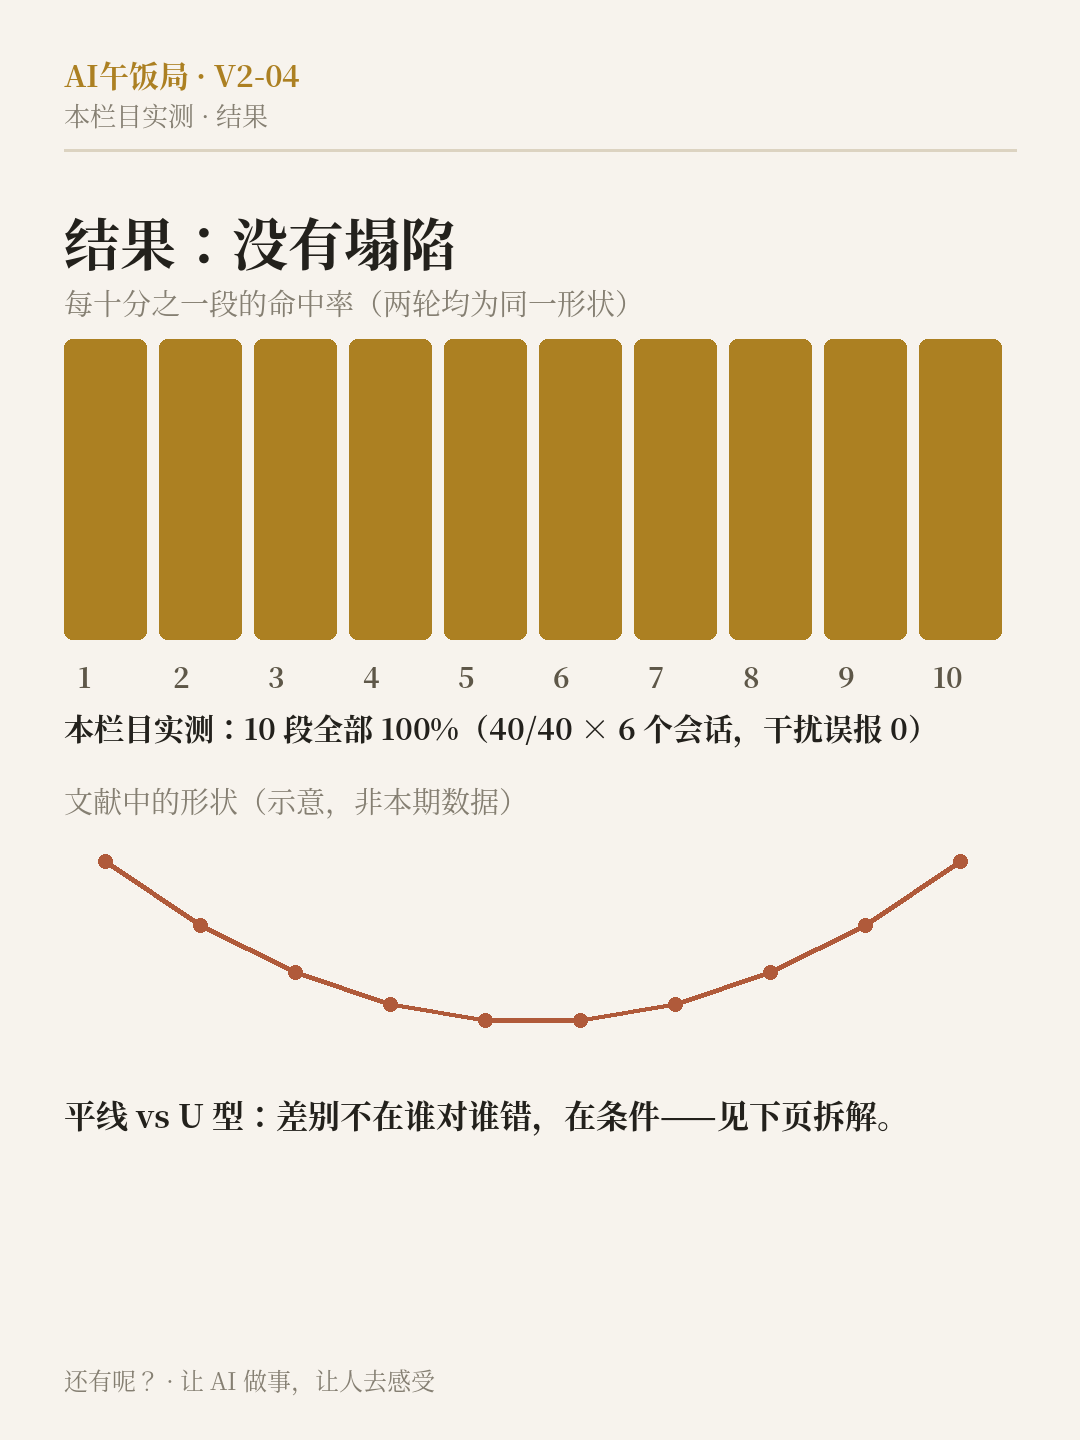
「AI 读长文会漏掉中间那段。」这句话你大概听过,它有正经出处:2023 年斯坦福等机构的研究《Lost in the Middle》发现,把答案藏在一堆文档的中间,模型的成绩会明显变差——开头和结尾记得牢,中间塌下去,画出来是一条 U 型曲线。
两年多过去了,模型换了几代,这个说法还成立吗?我们决定自己测,而且测两轮。
一、文献先说清:塌陷是在什么条件下测出来的
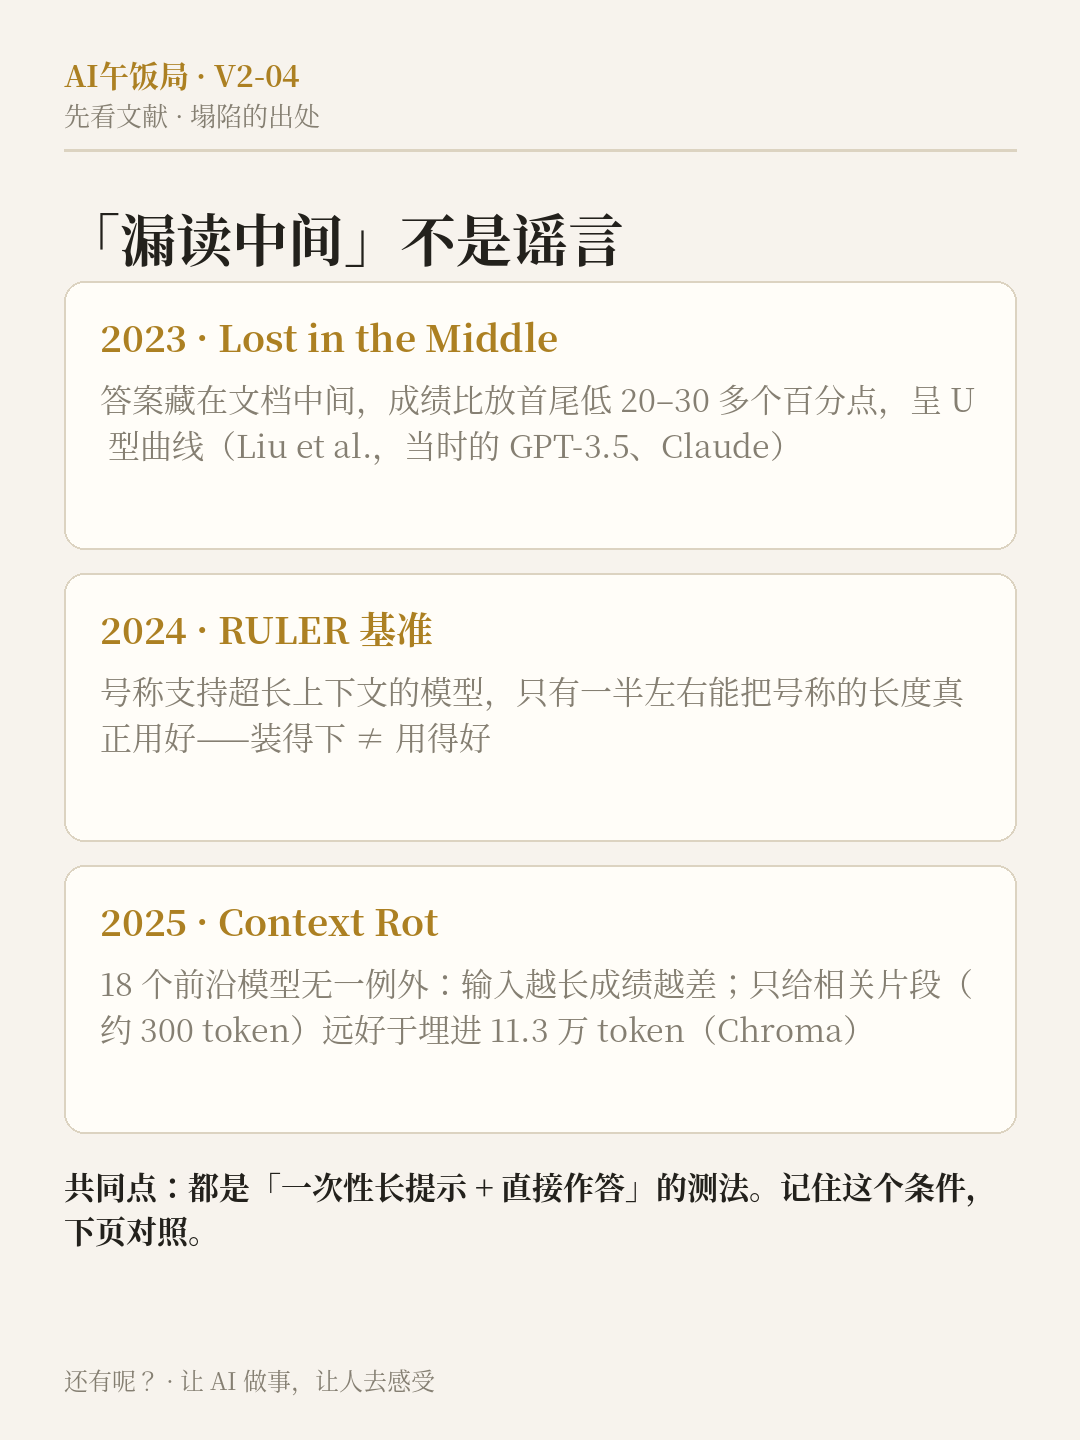
- Liu et al.(2023):多文档问答,答案文档的位置从头挪到尾。在部分配置下,答案位于中间时,成绩比位于首尾低 20–30 多个百分点。当时的受试者是 GPT-3.5、Claude 等 2023 年的模型,做法是把全部文档一次性放进提示词,直接提问。
- RULER(2024):号称支持 32K 以上上下文的模型里,只有一半左右能真正把 32K 用好——号称的长度,不等于有效的长度。
- Chroma《Context Rot》(2025):18 个前沿模型(Claude 4、GPT-4.1、Gemini 2.5 等)无一例外:输入越长,成绩越差,哪怕任务本身很简单。同一个问题,只给相关片段(约 300 token)答得明显好于把答案埋进 11.3 万 token 的完整记录里;干扰项和真答案长得越像,退化越快。
三项研究条件不同,但指向同一件事:在「一次性长提示 + 直接作答」的用法里,长和位置都在收税。
二、我们的实测:两轮,越测越狠
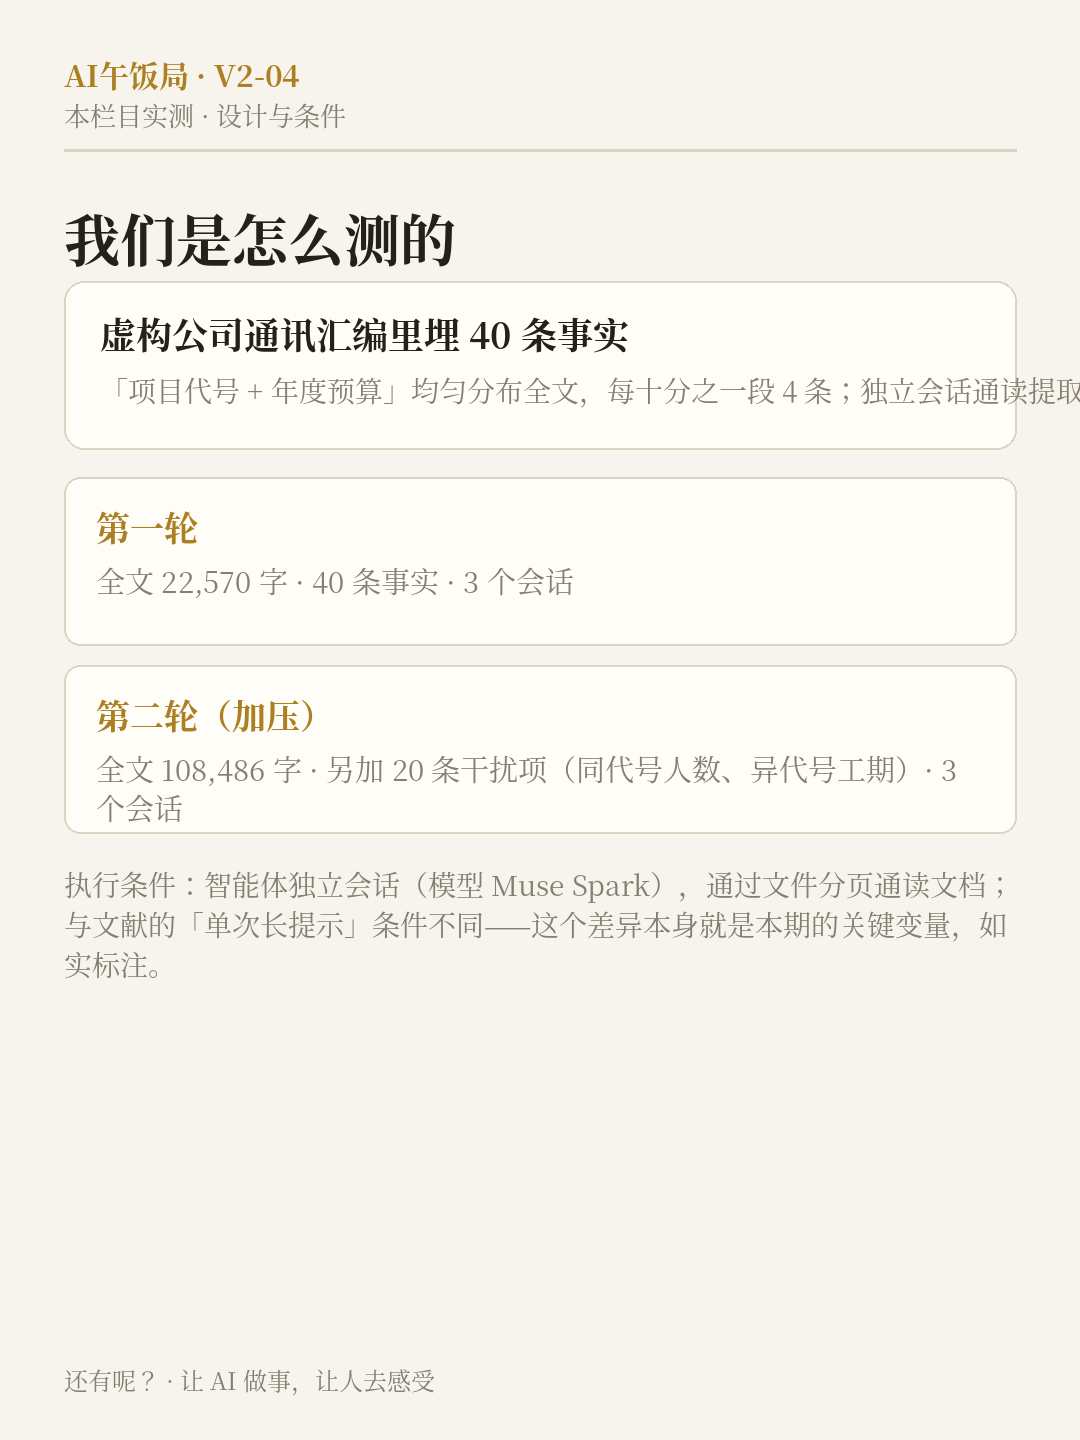
实验设计(完整档案见文末):编辑部生成虚构公司「蓝桥科技」的内部通讯汇编,把 40 条「项目代号 + 年度预算」事实均匀埋进全文(每十分之一段落 4 条),请独立会话通读全文、把 40 条全部提取出来,程序按位置判分。
- 第一轮:全文 22,570 字。结果:3 个会话全部 40/40,十个位置段命中率全是 100%。
- 第二轮(加压):全文拉到 108,486 字(接近 Chroma 实验的量级),另埋 20 条干扰项——同一代号的参与人数、别的代号的工期,专等它张冠李戴。结果:3 个会话依然全部 40/40,干扰误报 0 条,十个位置段仍是全 100%。
U 型曲线没有出现。不是没测出来,是在这个实验里它确实没发生。
三、为什么我们没复现?三个原因(编辑分析)
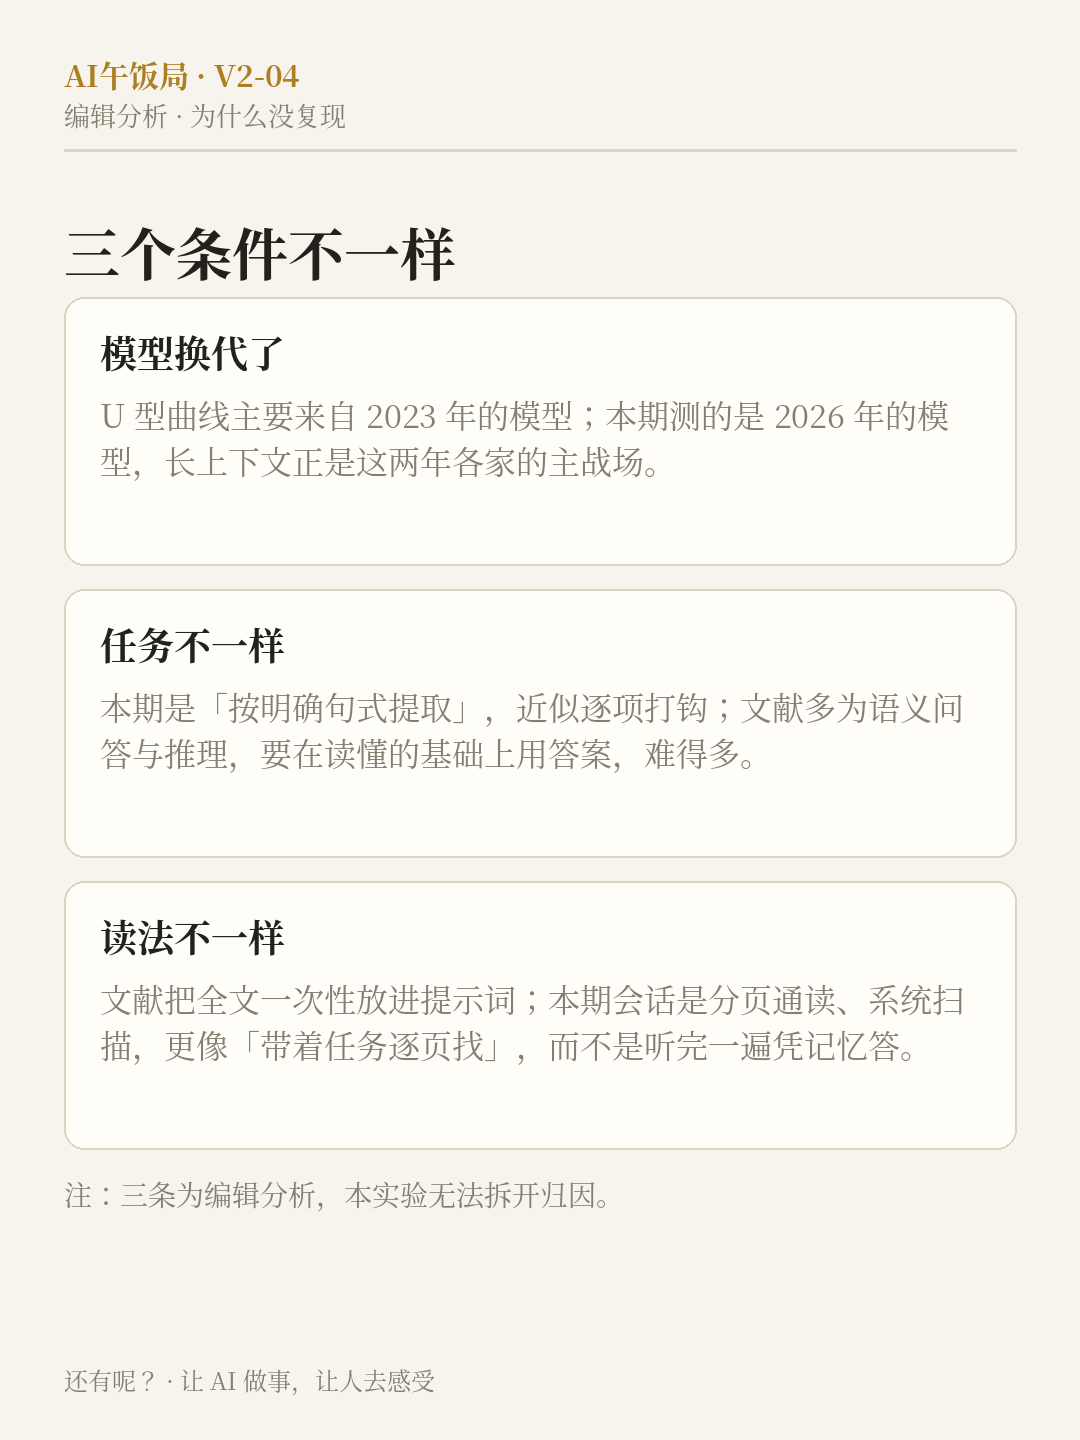
先把丑话说前面:我们的实验条件和文献不一样,这正是关键。[编辑分析] 差异至少有三处:
- 模型换代了。文献的 U 型曲线主要来自 2023 年的模型;我们测的是 2026 年的模型。两年里长上下文是各家主战场,进步真实存在。
- 任务不一样。我们要求的是「按明确句式提取事实」,接近拿着清单逐项打钩;文献测的多是语义问答和推理——要在读懂的基础上找答案、用答案,难度不在一个量级。Chroma 的数据也显示:任务越需要理解、干扰越像真答案,退化越明显。
- 读法不一样。文献是「一次性把全文放进提示词」;我们的答题会话是通过文件分页通读的智能体——它可以一段一段系统地扫过去,工作方式更像「带着任务逐页找」,而不是「听完一遍凭记忆答」。读法变了,结论就变了。
这三条在本实验里无法拆开归因,我们也不打算硬拆。但合起来足够支撑一个有用的判断——
四、结论:塌陷不是谎言,是用法说明书
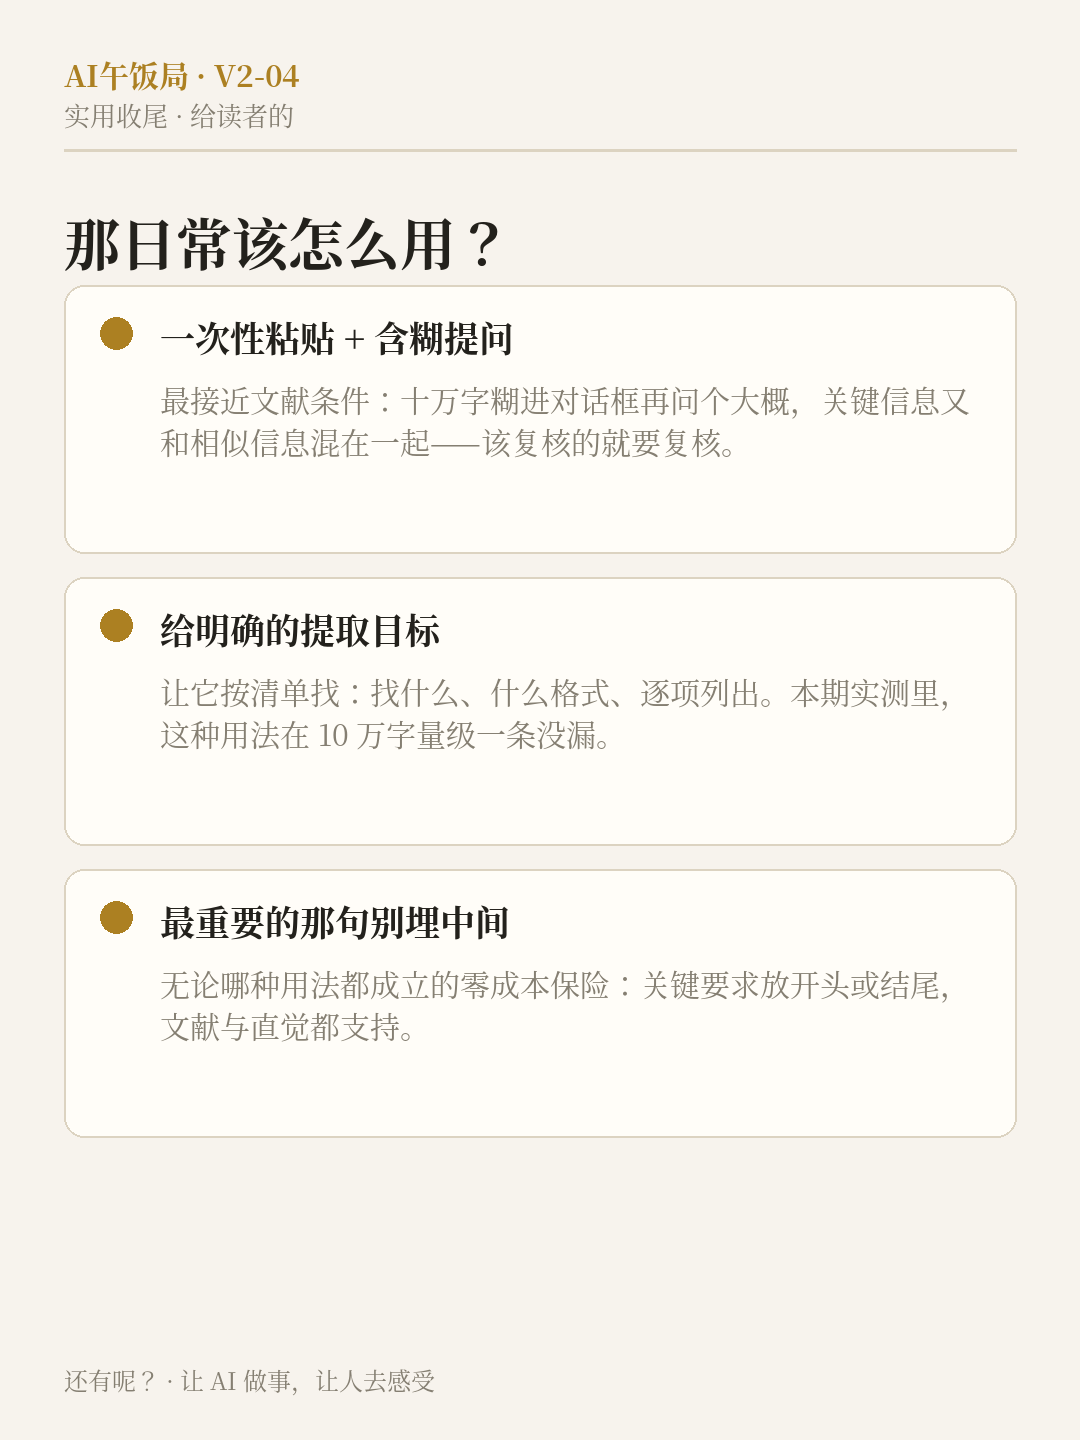
「AI 会漏读中间」不是过时的谣言,也不是普遍的真理,它是一条带条件的规律:
- 你把十万字一次性粘进对话框,问一个含糊的问题,关键信息还和一堆相似信息混在一起——文献的条件齐了,该小心的还是要小心。
- 你让 AI 工具(能读文件、能分段处理的那种)通读文档,并给它明确的提取目标——我们的实测说,在 10 万字量级上,它可以做到一条不漏。
- 无论哪种用法,最重要的那句话别埋在长文正中间——这是零成本的保险,文献和直觉都支持。
厂商宣传的「支持 100 万上下文」,说的是装得下;装得下、找得到、用得对,是三件事。这一期测的是中间那件:在合适的用法下,它比你想象的靠谱;在不合适的用法下,2023 年的警告到今天依然有效。
来源
- 本栏目实测(2026-11-04 执行,两轮共 6 个独立会话):实验文档、答案键、原始提取与判分记录见同目录
experiment/。 - Liu et al.《Lost in the Middle: How Language Models Use Long Contexts》,arXiv:2307.03172(2023;TACL 2024)— https://arxiv.org/abs/2307.03172
- Hsieh et al.《RULER: What's the Real Context Size of Your Long-Context Language Models?》,2024 — https://arxiv.org/abs/2404.06654
- Hong, Troynikov, Huber(Chroma)《Context Rot: How Increasing Input Tokens Impacts LLM Performance》,2025-07(技术报告,非同行评议)— https://research.trychroma.com/context-rot
*标注:实测结论仅适用于「智能体分页通读 + 明确提取任务 + 本模型」条件;文献条件(单次长提示、语义问答)不在本实测覆盖范围内,两边结论不互相否定。*