换一种问法,AI 的回答真的会变好吗?
本期含 [本栏目实测] 内容,已连同完整实验条件标注;文献数字均为 [已核实事实] 并标注年代与出处;解释性判断标为 [编辑推测]。
完整文字版与来源
开场:先说我们测出了什么
「请一步一步想」「你是一位顶尖专家」「我给你 200 美元小费」——网上流传着大量「这样问,AI 答得更好」的技巧。我们决定不转述,自己测。
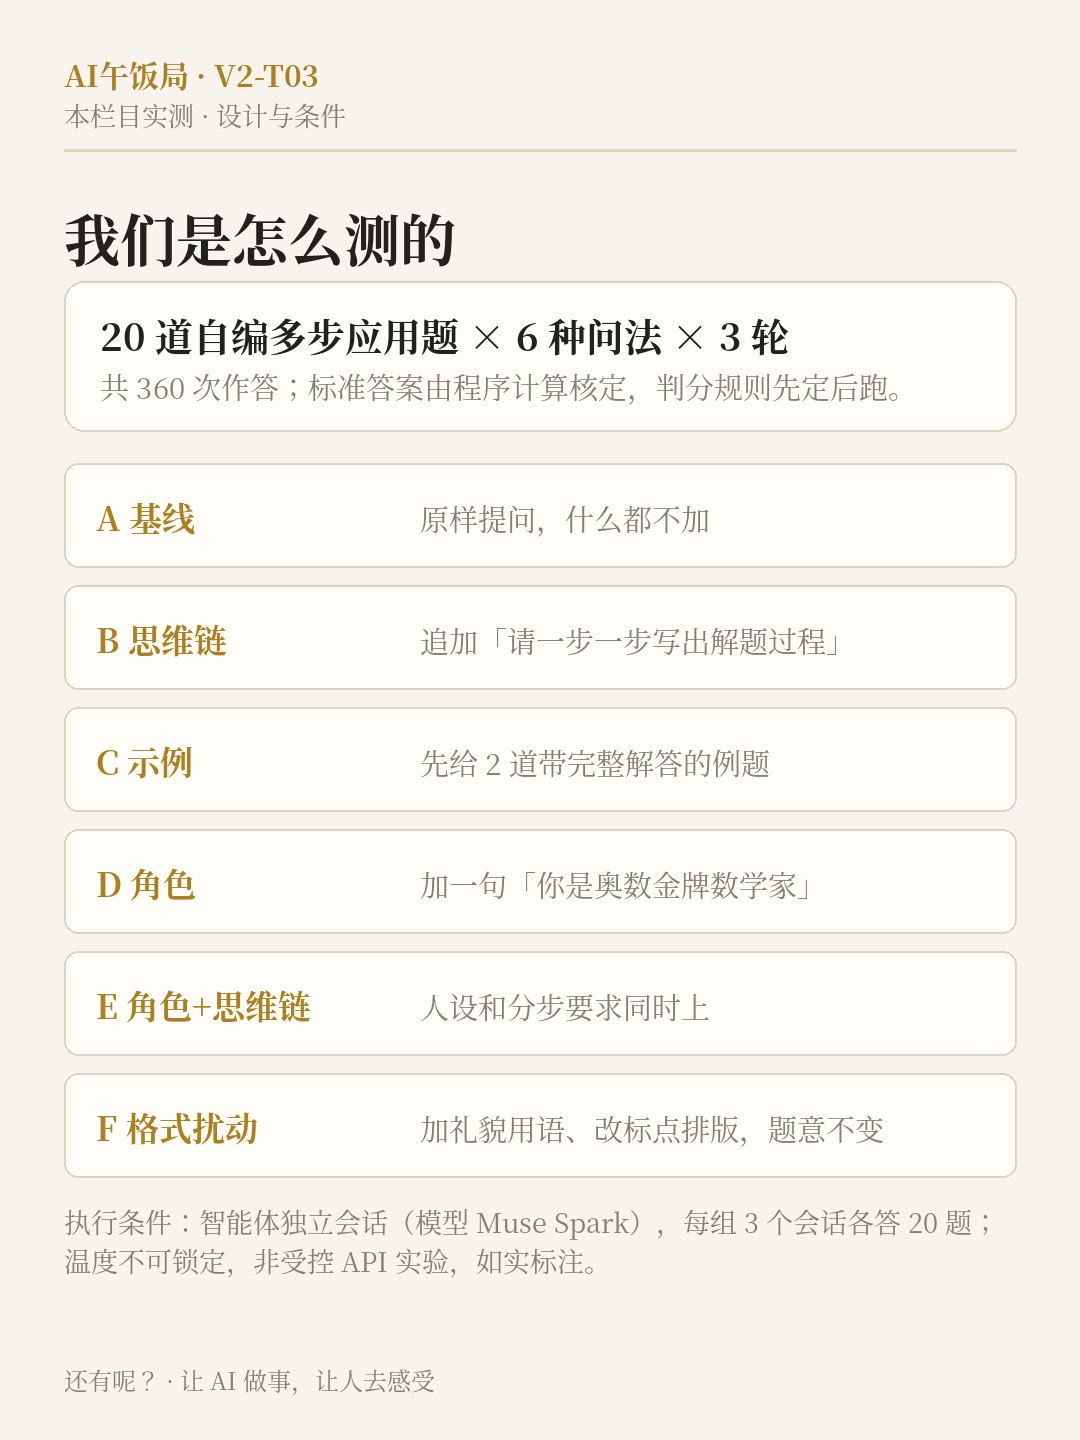
测试很简单:编辑部自编 20 道多步应用题(折扣税费、浓度混合、追及问题、复利……),用 6 种问法各问 3 轮,共 360 次作答,答案预先由程序算好、判分规则先定后跑。
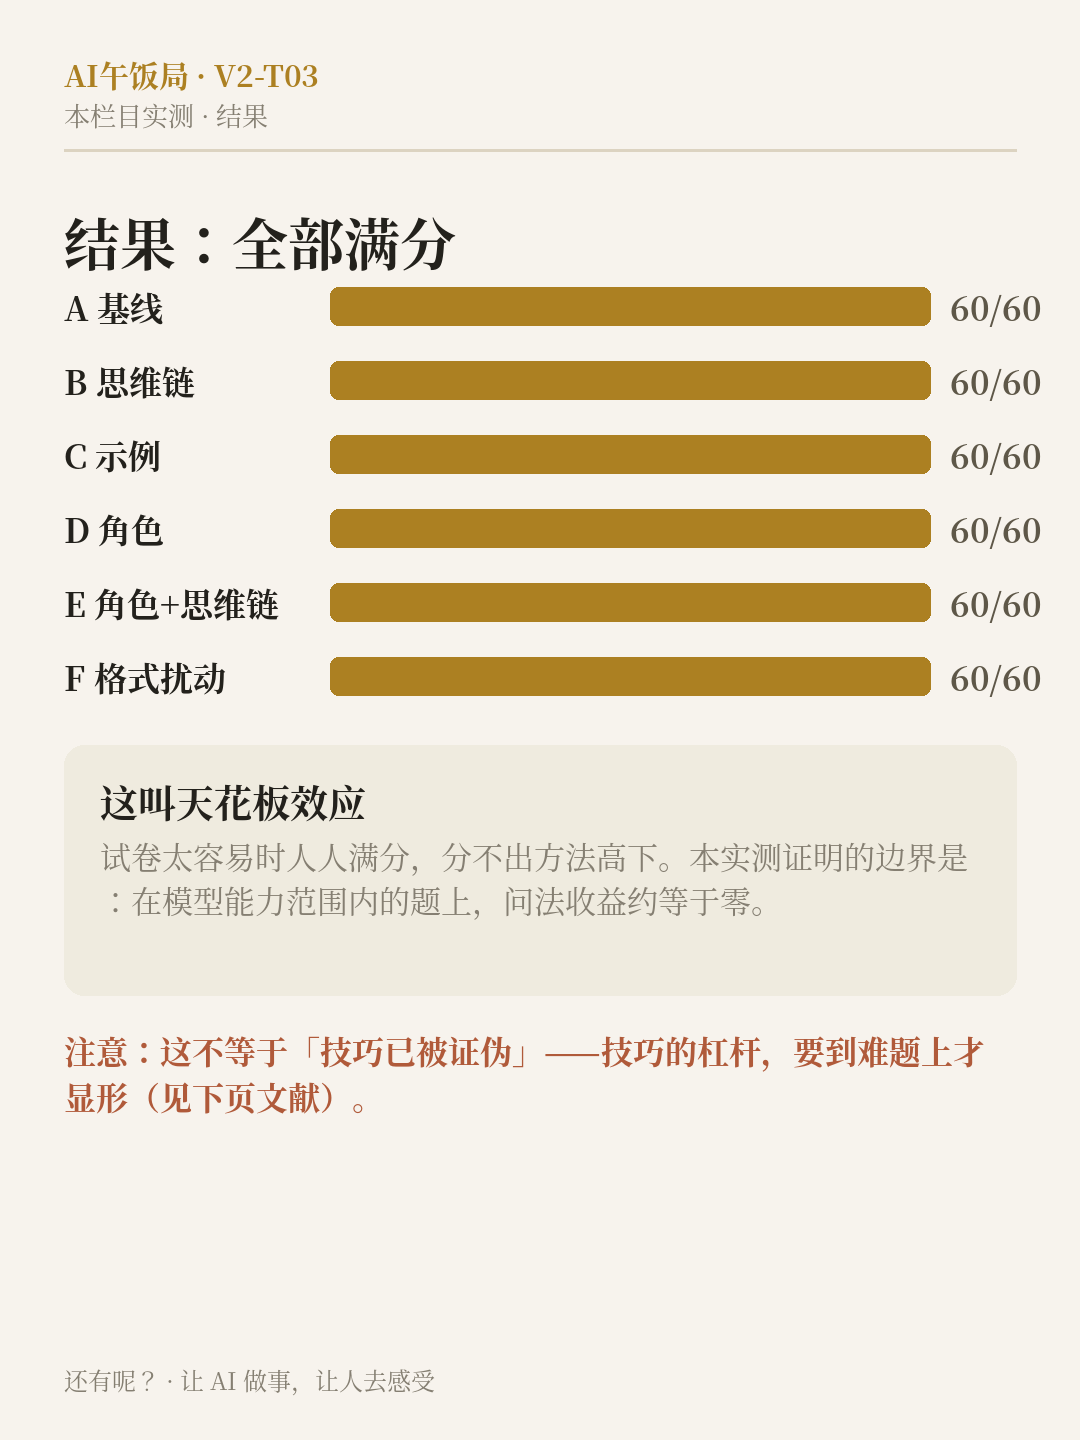
结果:六组全部 60/60 满分。基线问法满分,要求一步一步想满分,给示例满分,扮演奥数金牌选手满分,把题目改得礼貌又啰嗦——还是满分。
这不是我们预期的结果。但它恰好是最值得讲的结果。
一、实验条件,先交代清楚
按本栏目的规矩,实测必须连条件一起说:
- 题目:编辑部自编 20 道多步应用题,答案由程序计算核定,不依赖人工出题者的手算。
- 问法 6 组:A 原样提问(基线);B 追加「请一步一步写出解题过程」;C 先给 2 道带完整解答的例题;D 加一句「你是一位获得国际数学奥林匹克金牌的数学家」;E 角色 + 一步一步;F 格式扰动(加礼貌用语、改标点排版、换编号样式,题意不变)。
- 执行通道:本栏目的智能体独立会话,模型为 Muse Spark;每组 3 个互不共享上下文的会话,各答全部 20 题。温度等参数不可锁定,这是智能体通道、不是受控 API 实验——这一点不遮掩。
- 判分:最终数值与标准答案比对,容差 0.011;个别会话未按约定格式收尾的,按题序提取每题最终数值判分,规则对所有组一致。
结论的有效范围也就到此为止:这个模型、这类难度、这批题。下面这句话请和结果一起读——
二、满分不等于「技巧没用」,等于「题目太简单」
六组全对,统计上叫天花板效应:试卷太容易时,所有考生都是满分,你分不出谁的方法更好。这批题对 2026 年的强模型来说,就是太容易了:多步应用题的每一步,它都游刃有余,问法带来的扰动还没大到能让它算错。
所以本期实测真正证明的是一个边界:在模型能力范围之内的任务上,问法技巧的收益约等于零。技巧有没有价值,要到难题上才看得见——这正是文献里那些惊人数字的来源语境。
三、文献里的「大数字」,都带着年代
把经典研究摆出来,注意看年份和当时的模型:
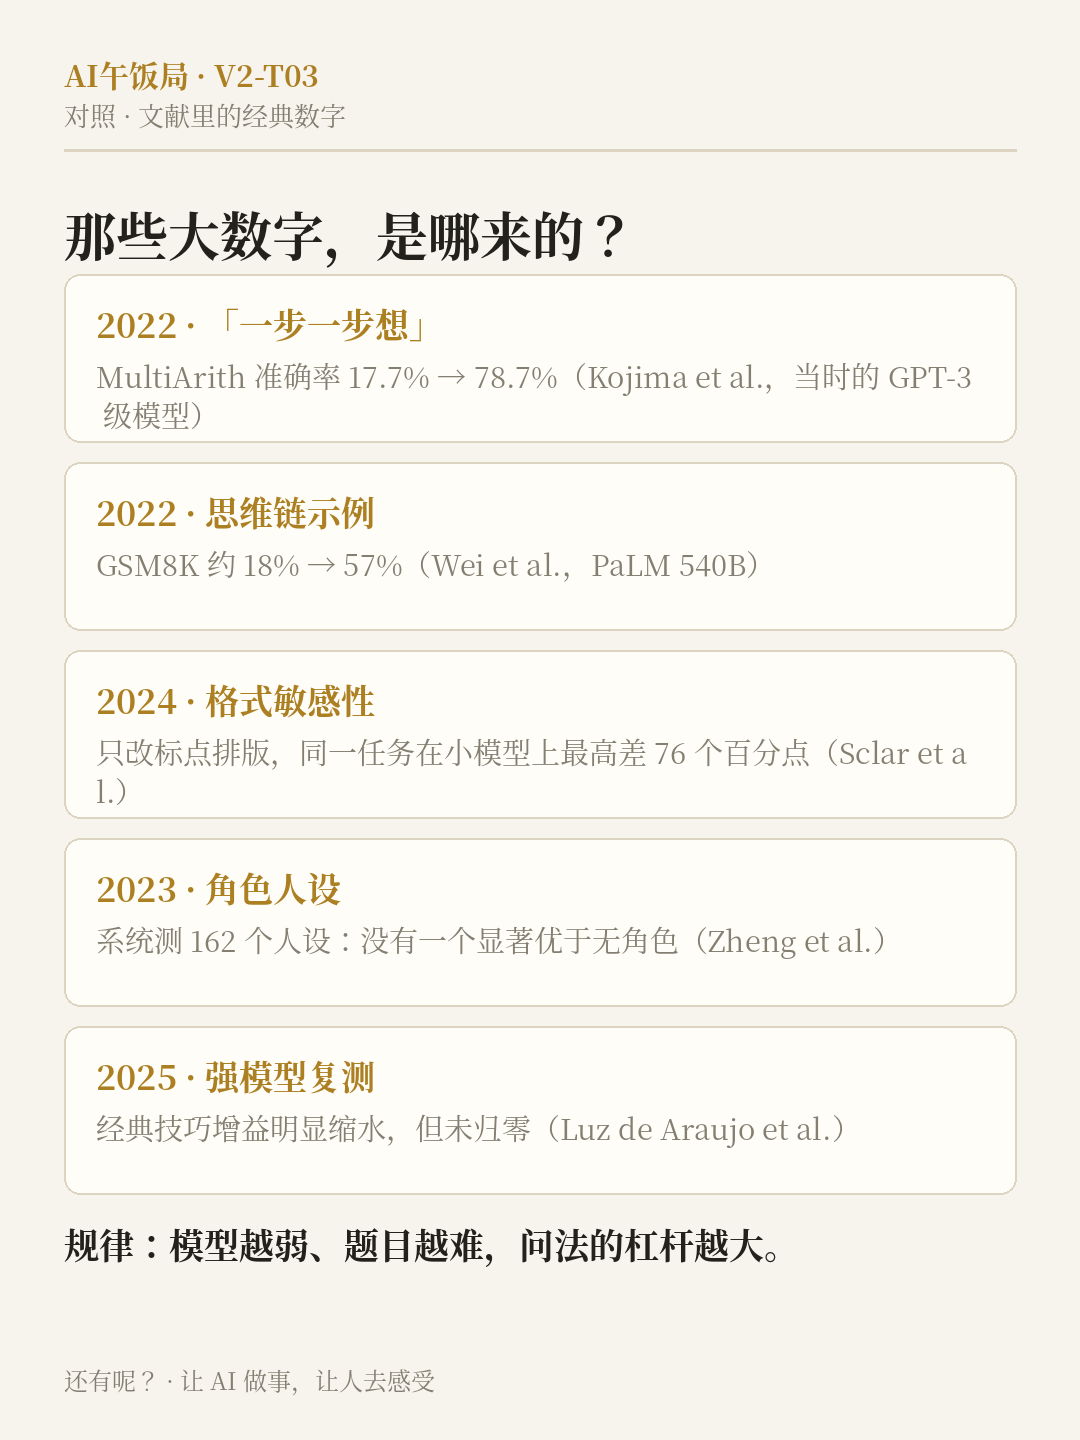
- 「一步一步想」(Kojima et al., 2022):在 MultiArith 上,零样本只加这句话,准确率从 17.7% 跳到 78.7%。当时的模型是 GPT-3 级别。
- 思维链示例(Wei et al., 2022):给带推理过程的示例,PaLM 540B 在 GSM8K 上从约 18% 升到约 57%。
- 示例的关键可能不是内容(Min et al., 2022):把示例的答案标签随机打乱,成绩几乎不掉——示例教会模型的主要是「格式和套路」,未必是知识。
- 格式敏感性(Sclar et al., ICLR 2024):在较小的模型上,只改格式(标点、空格、分隔符),同一任务成绩最高能差 76 个百分点。
- 换到强模型,收益缩水但未归零(Luz de Araujo et al., 2025):在较新的模型上,经典提示技巧的增益明显变小,但不是完全消失。
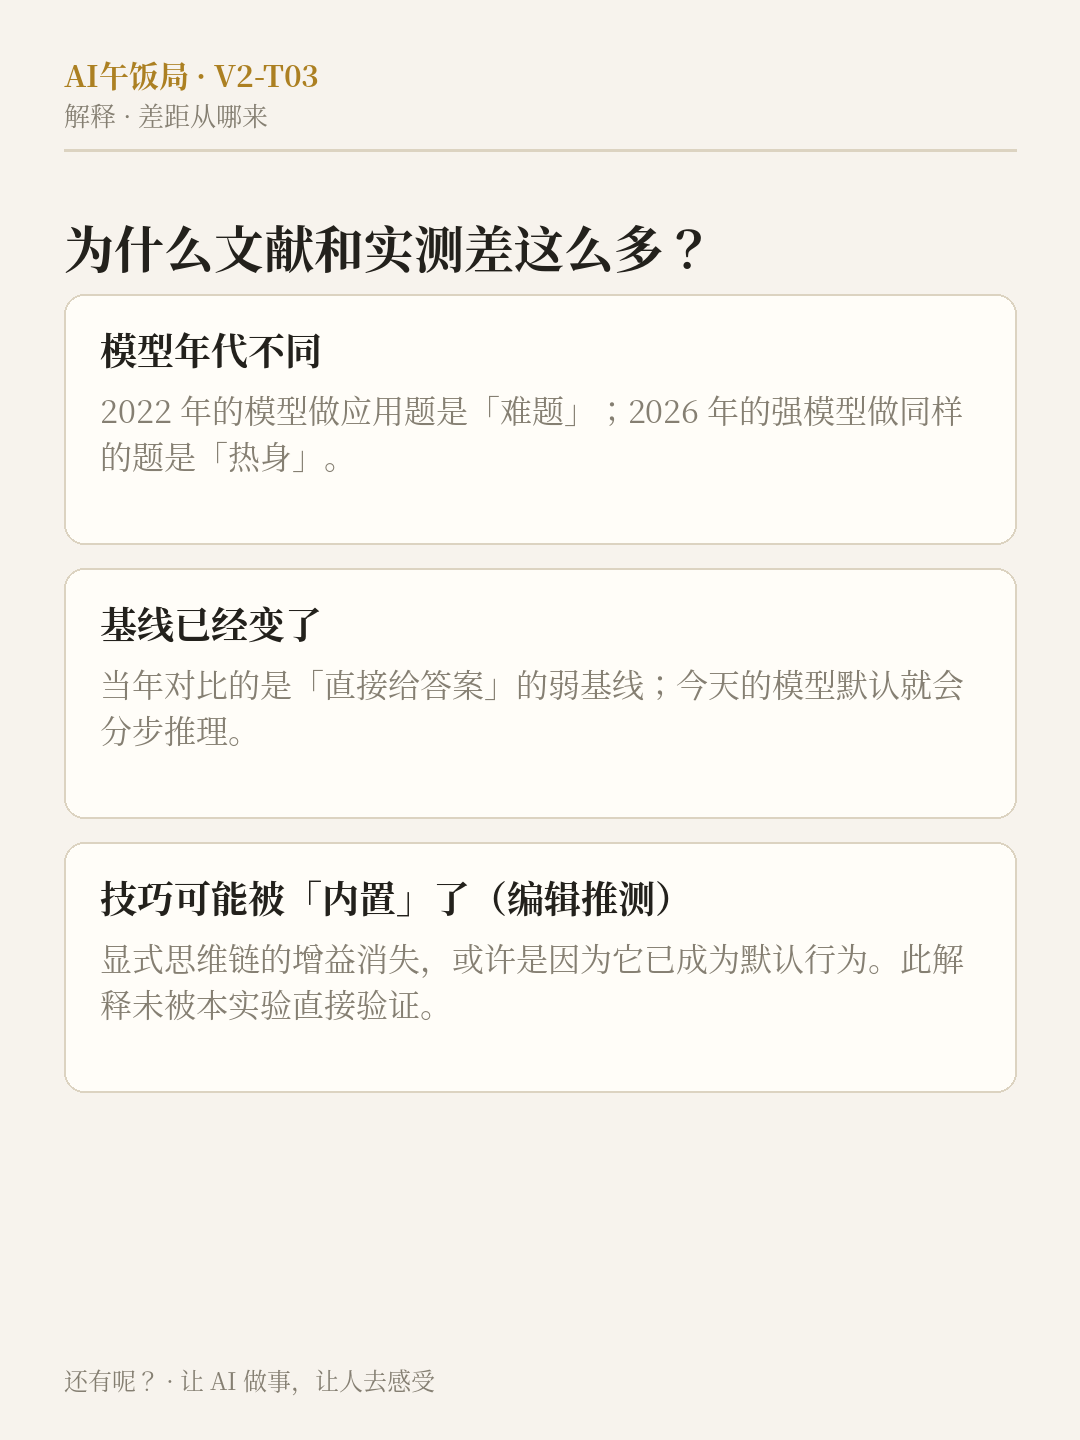
规律很清楚:模型越弱、题目越难,问法的杠杆越大。2022 年的模型做小学数学应用题是「难题」,2026 年的强模型做同样的题是「热身」。
四、那「你是一位专家」和「谢谢」到底有用吗
单独说角色人设,因为它流传最广:
- Zheng et al.(2023)系统测了 162 个人设:没有任何一个显著优于无角色基线。
- Kong et al.(2023)发现:领域专家人设偶尔的增益,很可能来自它顺带触发了分步推理——是「隐性思维链」,不是人设本身。
- 至于「给小费」「请和谢谢」能提升正确率的说法:没有同行评议证据,属于都市传说级别。
本期实测与这条文献线一致:D 组(金牌人设)和 E 组(人设 + 思维链)都是 60/60,和基线没有任何差距——当然,因为基线也满分,这个「一致」只能算弱证据,我们如实标注。
[编辑推测] 一个可能的解释是:现代强模型在训练后默认就会分步推理,等于把当年的「思维链技巧」内置成了默认行为;当默认值已经包含技巧,显式再说一遍自然测不出增量。这个解释与 2025 年复测的趋势吻合,但没有被本期实验直接验证。
五、落到日常:该怎么问
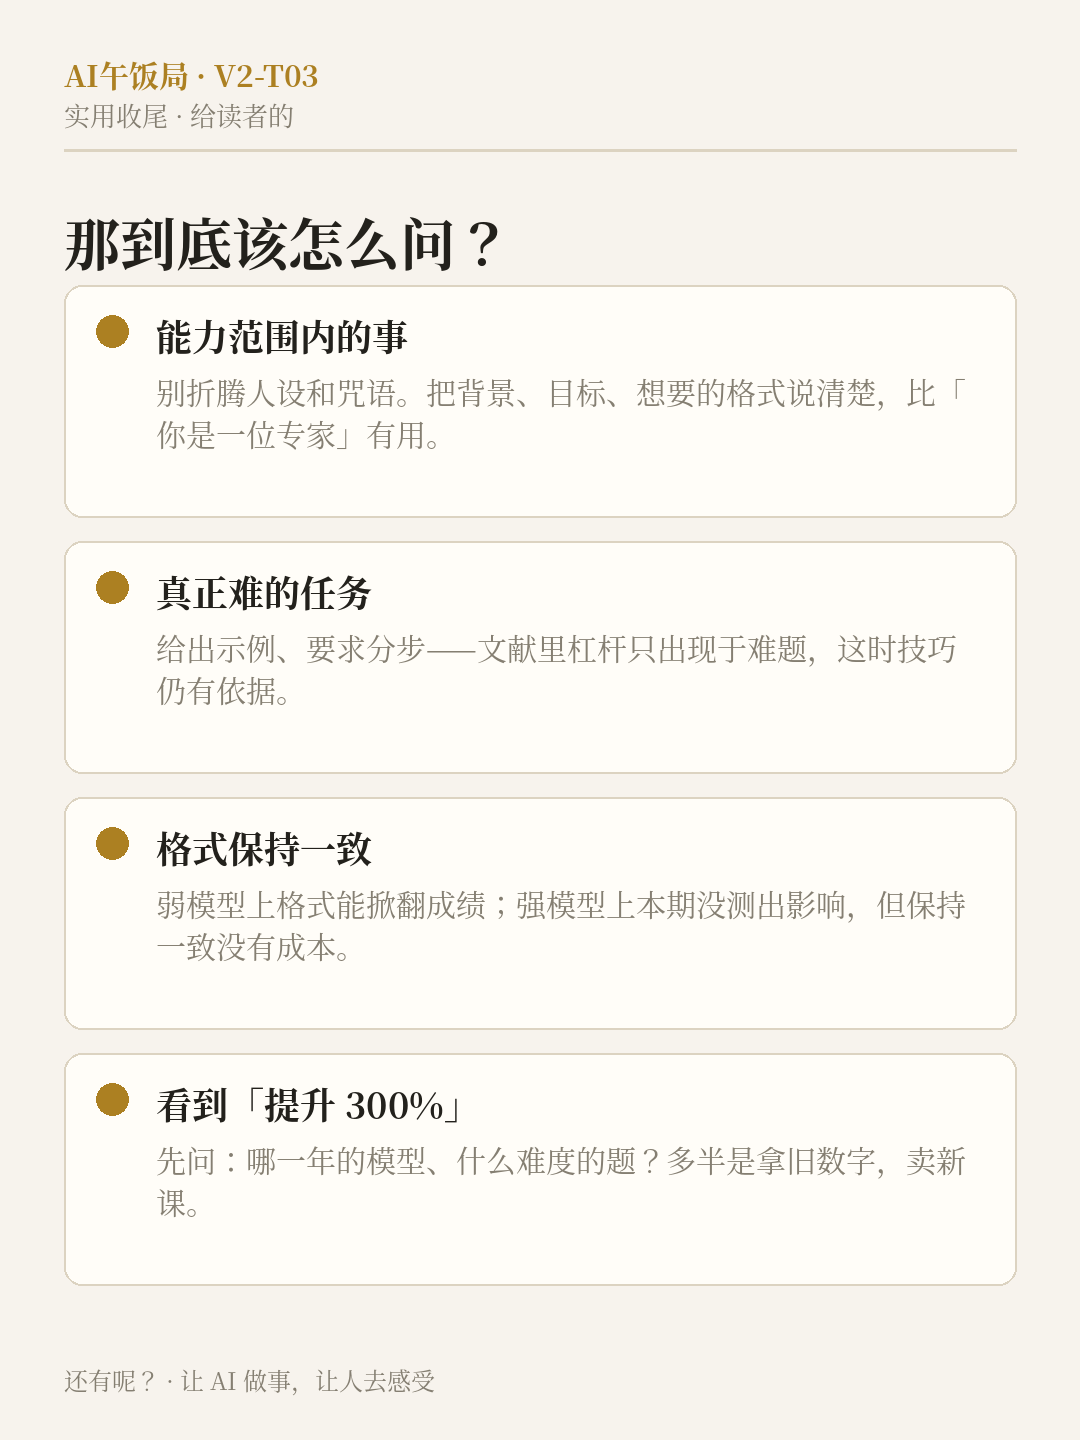
- 任务在它能力范围内(日常问答、常规写作、简单计算):别折腾人设和咒语,把问题本身说清楚最重要——背景、目标、格式要求,比「你是一位专家」有用得多(这是从「变量控制」的角度给的编辑建议)。
- 任务真的难(多步推理、复杂约束):给出示例、要求分步,仍有文献依据——杠杆在难题上才出现。
- 格式别乱改:弱模型上格式能掀翻成绩;强模型上本期没测出影响,但保持一致格式没有成本。
- 看到「问法提升 300%」类内容:先问一句——哪一年的模型、什么难度的题?十有八九,是拿旧模型的数字,卖新模型的课。
来源
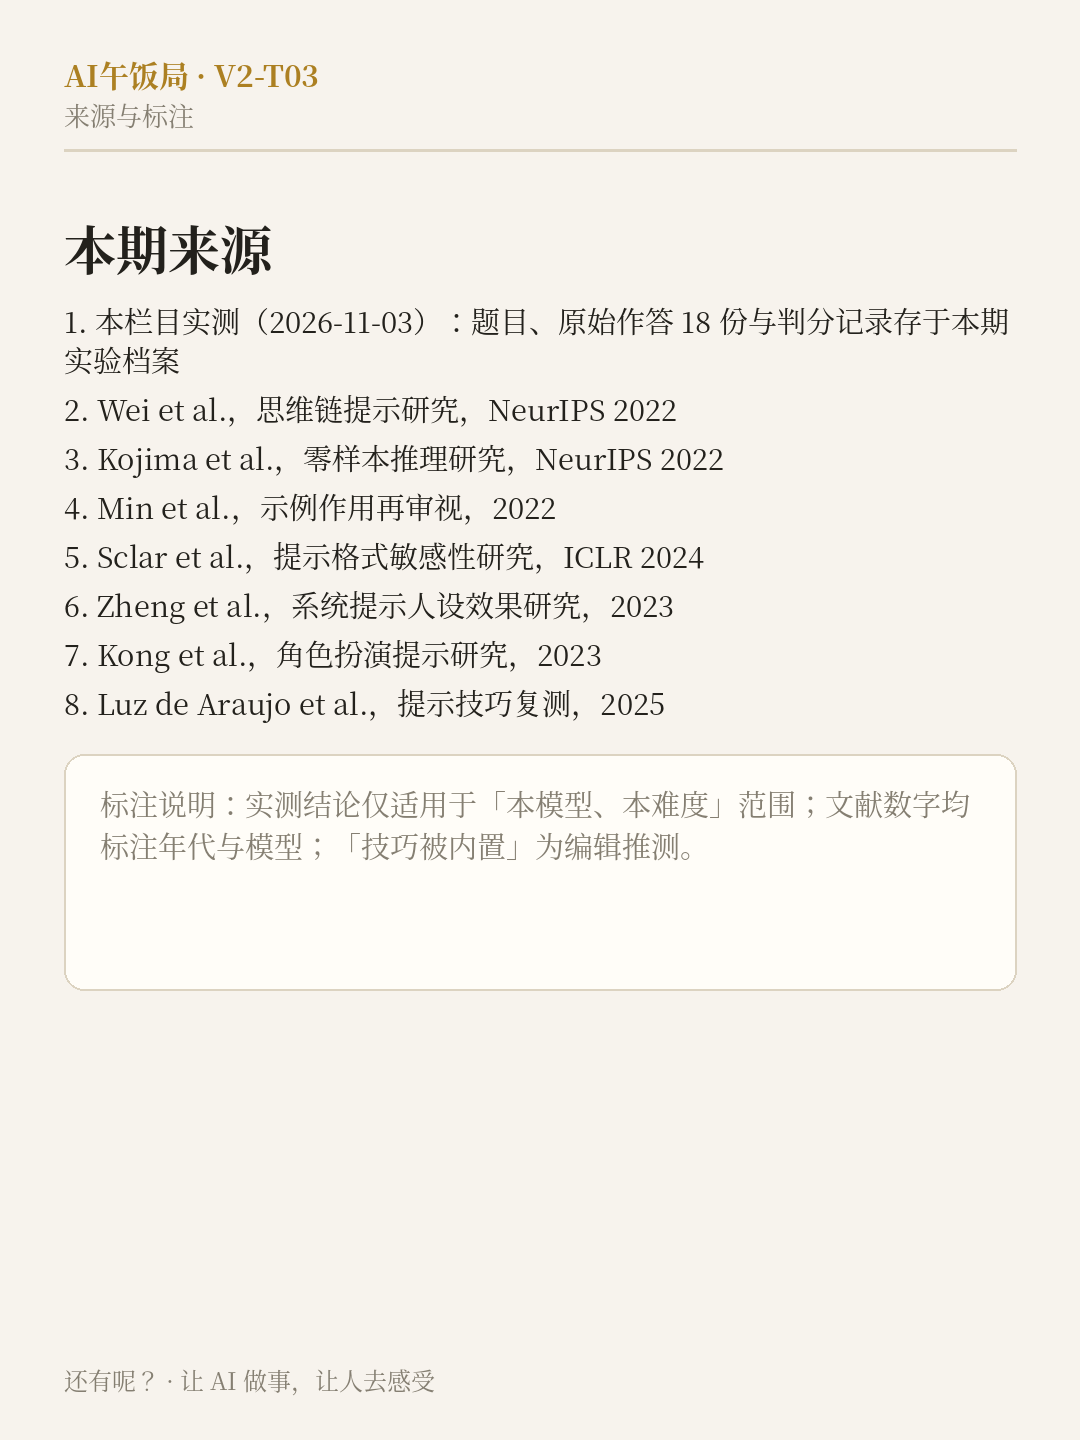
- 本栏目实测(2026-11-03 执行):实验设计、原始作答与判分记录见同目录
experiment/(problems_public.json、answer_key.json、raw/ 18 份原始作答、results.json)。 - Wei et al.,思维链提示研究,NeurIPS 2022 — https://arxiv.org/abs/2201.11903
- Kojima et al.,零样本推理研究(「一步一步想」),NeurIPS 2022 — https://arxiv.org/abs/2205.11916
- Brown et al.,少样本学习研究,NeurIPS 2020 — https://arxiv.org/abs/2005.14165
- Min et al.,示例作用再审视,2022 — https://arxiv.org/abs/2202.12837
- Sclar et al.,提示格式敏感性研究,ICLR 2024 — https://arxiv.org/abs/2310.11324
- Zheng et al.,系统提示人设效果研究,2023 — https://arxiv.org/abs/2311.10054
- Kong et al.,角色扮演提示研究,2023 — https://arxiv.org/abs/2308.07702
- Luz de Araujo et al.,提示技巧在新模型上的复测,2025 — https://arxiv.org/abs/2508.19764
*标注:文献数字均为原论文口径,已标注模型与年代;「默认内置思维链」为编辑推测,已在正文标注。本期结论仅适用于实验条件范围,不得引用为「提示词技巧已被证伪」。*