AI 数得清一句话里有几个字吗?
本期包含本栏目实测。实验条件、局限和资料来源见正文。
完整文字版与来源
一个流传最广的 AI 笑话
「strawberry(草莓)里有几个字母 r?」正确答案是 3 个。过去几年,拿这道题去问 AI,经常得到自信满满的「2 个」——一个能写代码、能讲量子力学的模型,栽在一道六岁小孩都会的题上。这个笑话流传之广,以至于有了专名:「草莓问题」。
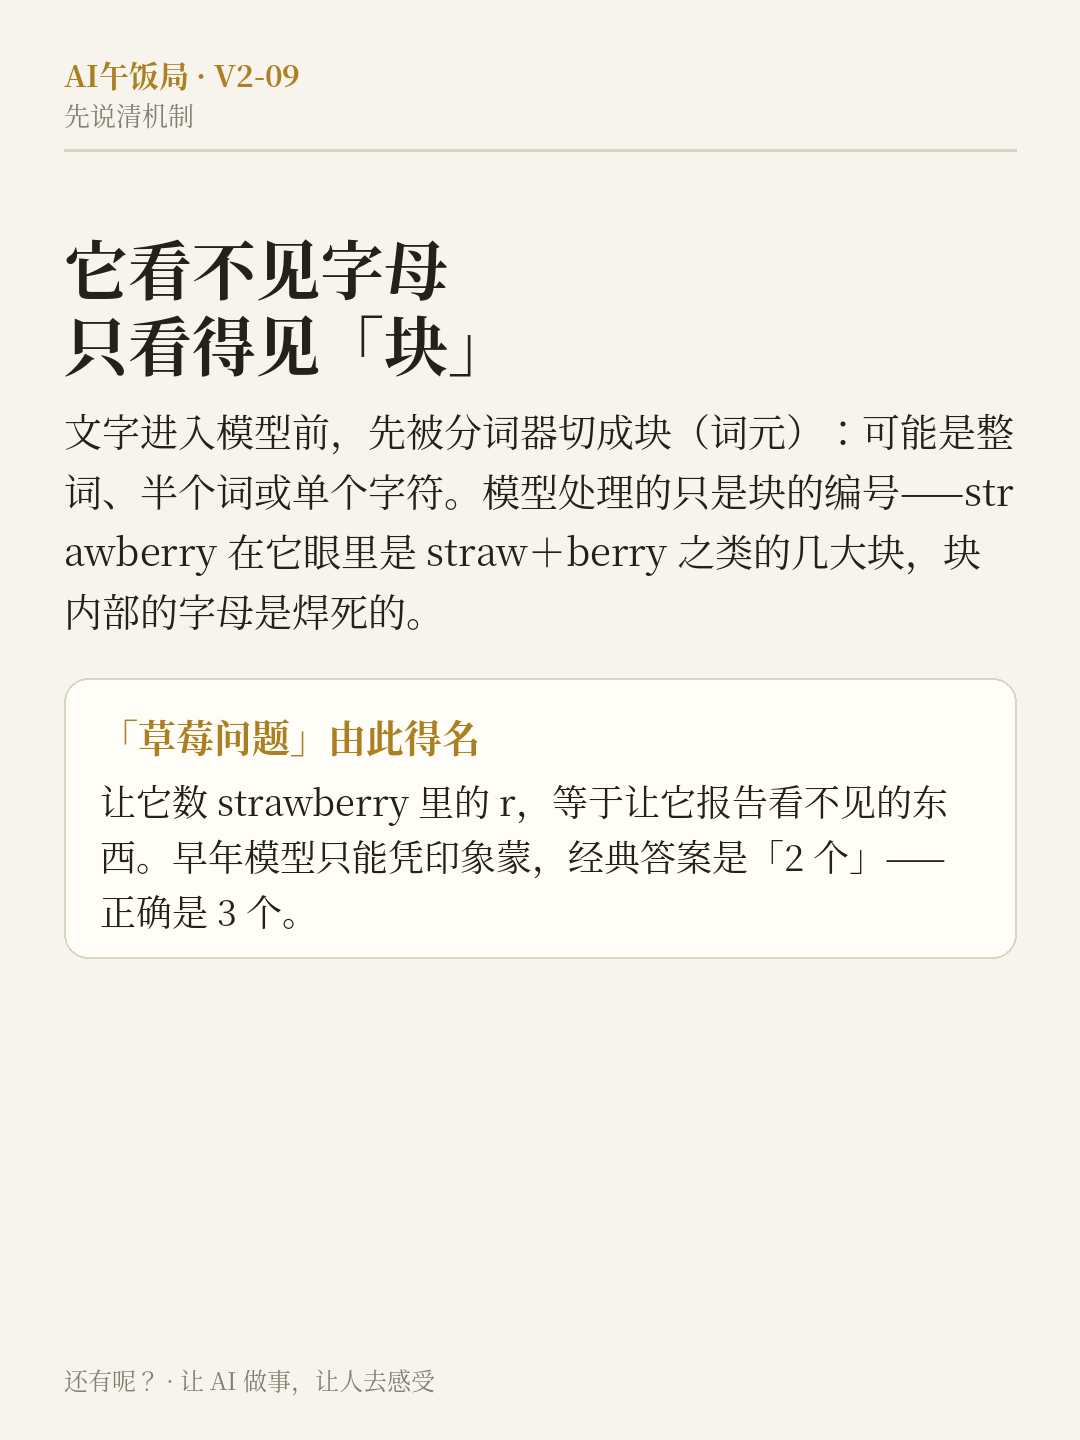
它背后有一个真实的机制,值得先讲清:AI 根本看不见字母。
你输入的文字在进入模型之前,会被一个叫分词器的程序切成块(术语叫 token,词元)。常用的切法叫 BPE:出现越频繁的字母组合,越早被合并成一整块。所以「strawberry」在模型眼里不是 s-t-r-a-w-b-e-r-r-y 十个字母,而是类似 straw+berry 这样的几大块,它处理的只是这些块的编号。块内部的字母是焊死的——让它数 r 的个数,等于让它报告自己看不见的东西。早年的模型只能凭统计印象蒙一个,蒙出「2」毫不奇怪。
顺着这个机制能推出一组预测:数英文单词个数应该相对容易(词与词之间有空格,和切块大致对齐);数汉字应该也不难(汉字通常一个字就是一块,看得见);最难的应该是数英文单词内部的字母、以及数被切得乱七八糟的长数字串。
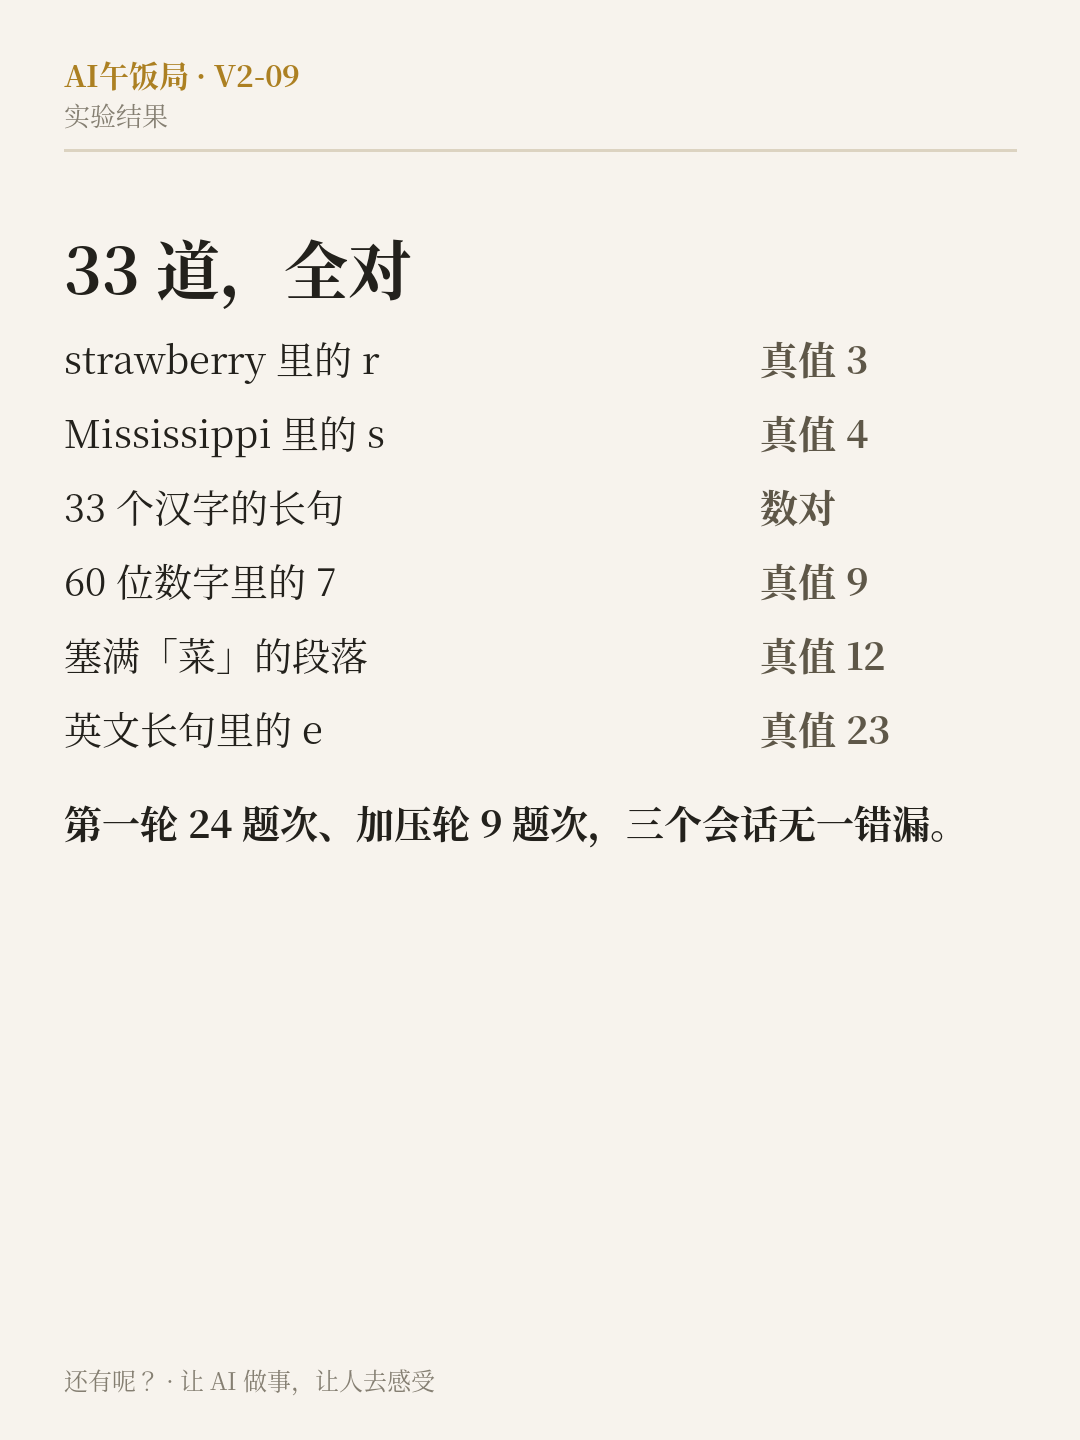
我们的实测:两轮,33 道,全对
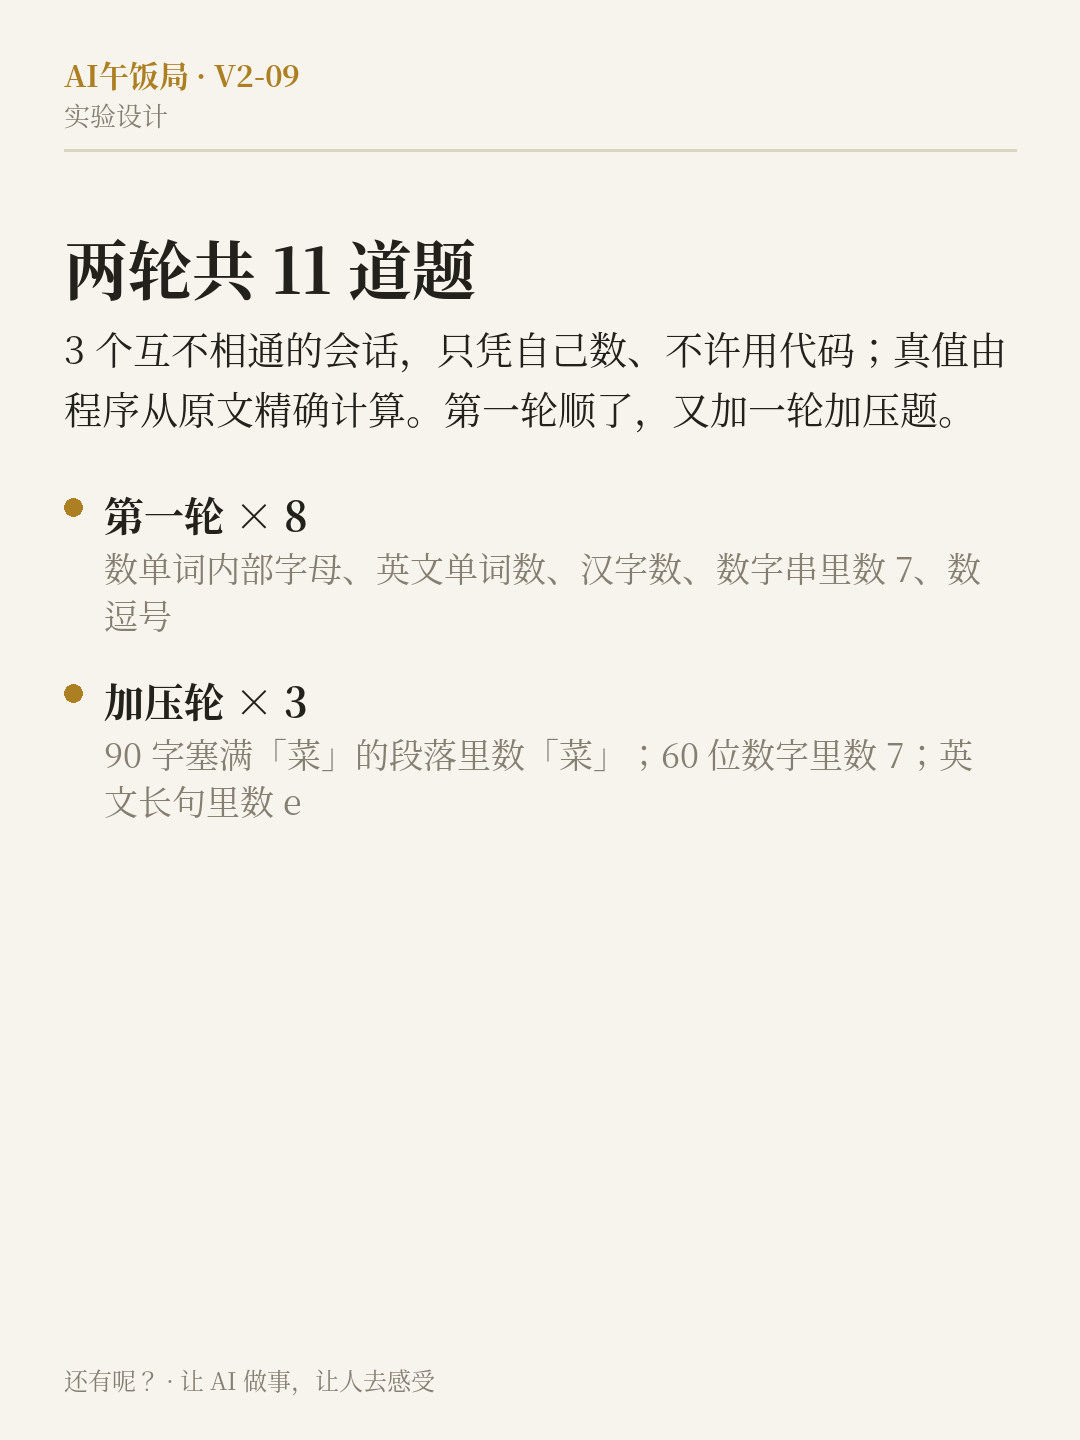
我们让 3 个互不相通的会话做计数题,真值由程序从原文精确计算,会话被要求只凭自己数、不许用代码。第一轮 8 道:
- strawberry 里 r 的个数:3 ✓
- Mississippi 里 s 的个数:4 ✓
- 一句英文(The quick brown fox…)的单词数:9 ✓
- 12 个汉字的短句、33 个汉字的长句:都数对 ✓
- 12 位数字串里 7 出现几次:6 ✓
- 一句话里逗号的个数:1 ✓
24 个题次,全对。我们不甘心,又加了一轮加压题:一段约 90 字、塞满「菜」字的段落(白菜、青菜、芹菜、香菜、菠菜、油菜……)里数「菜」出现几次——真值 12;一串 60 位数字里数 7——真值 9;一句 17 个词的英文里数字母 e——真值 23。三个会话,依然全对。合计 33/33。
机制没变,变的是解题方法
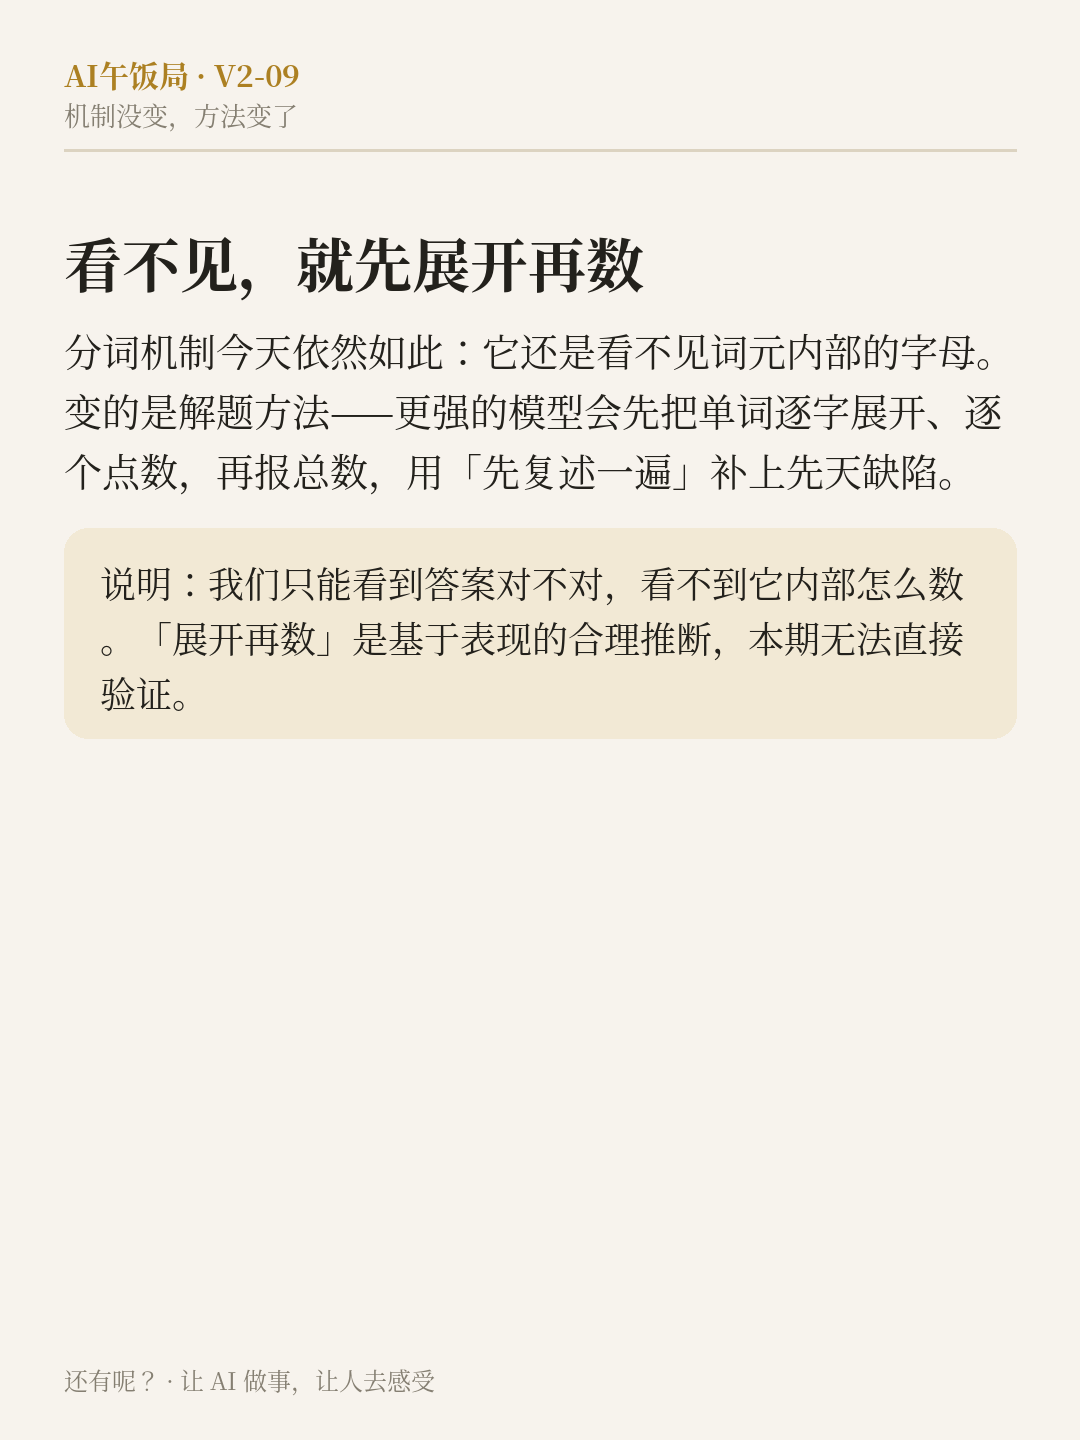
分词的机制到今天没有变:模型依然看不见词元内部的字母。变的是它处理这类题的方法——更强的模型在数之前会先把单词在心里逐字展开、逐个点数,再给出总数,相当于把「看不见」用「先复述一遍」补上。需要说明:我们只能看到它的答案对不对,看不到它内部到底怎么数,所以「它学会了展开再数」是基于其表现的合理推断,本期无法直接验证。
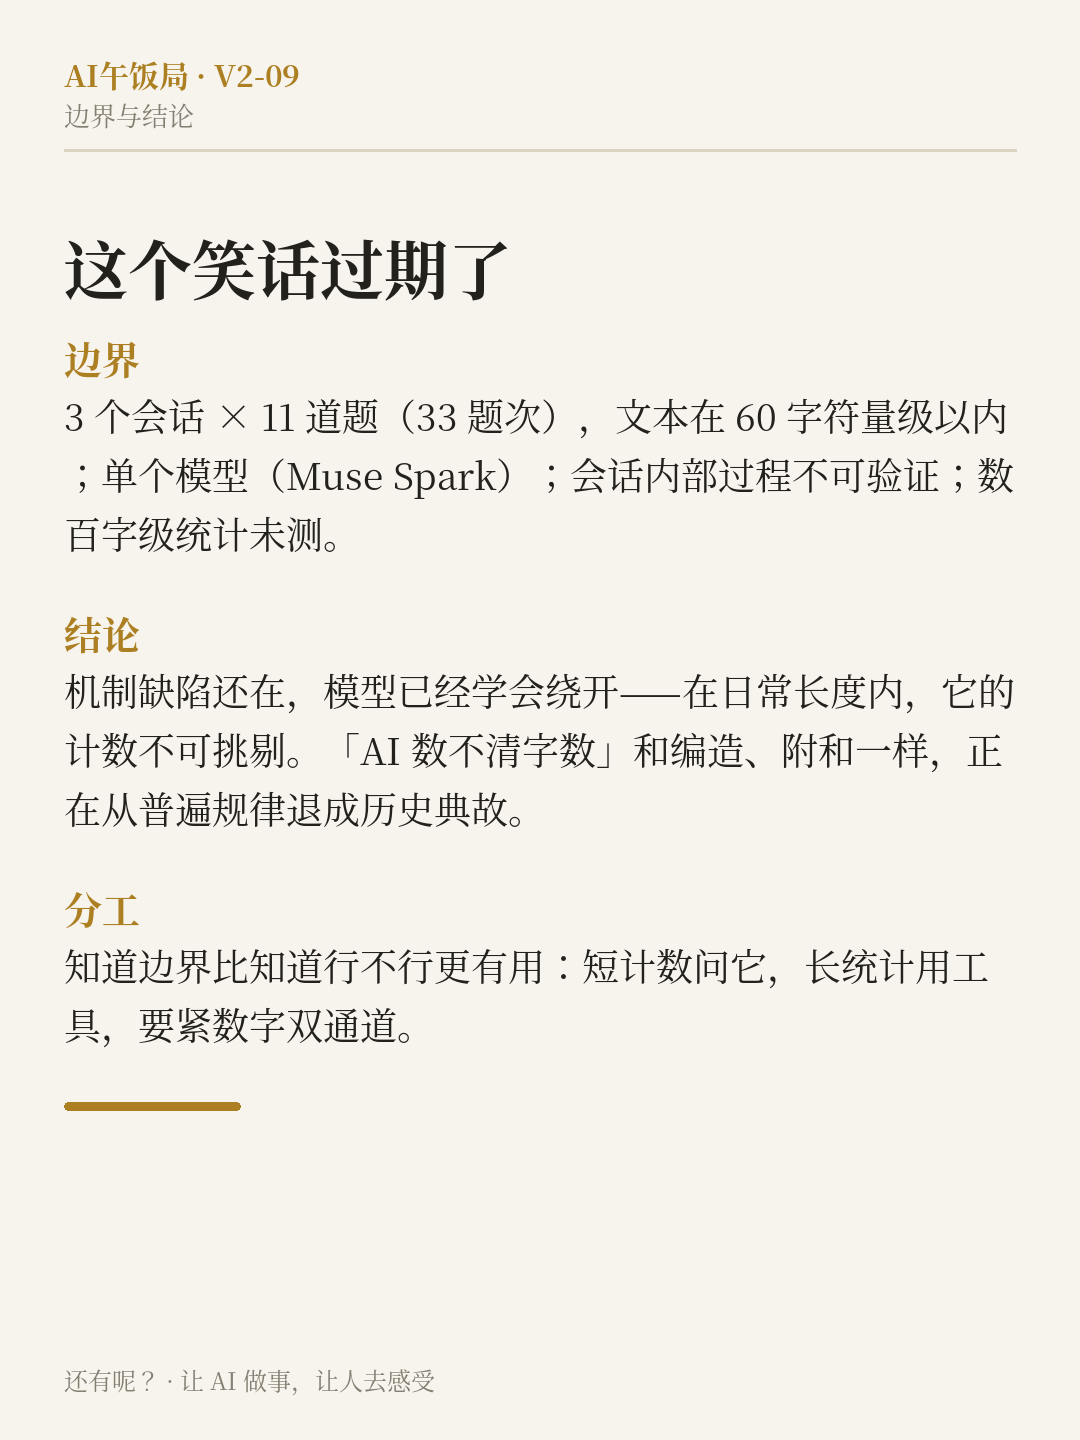
不管过程如何,结论很清楚:在日常长度内(几十个字符、高重复段落),「AI 数不清字数」这个笑话已经过期了。这和本刊最近几期的实测走向一致:编造、附和、忘词、被错误前提带跑——2023 年前后的经典指控,正在一条一条地从「普遍规律」退成「历史典故」。机制缺陷还在那里,但模型学会了绕着走。
还剩下什么要注意的
有两条边界仍然成立:
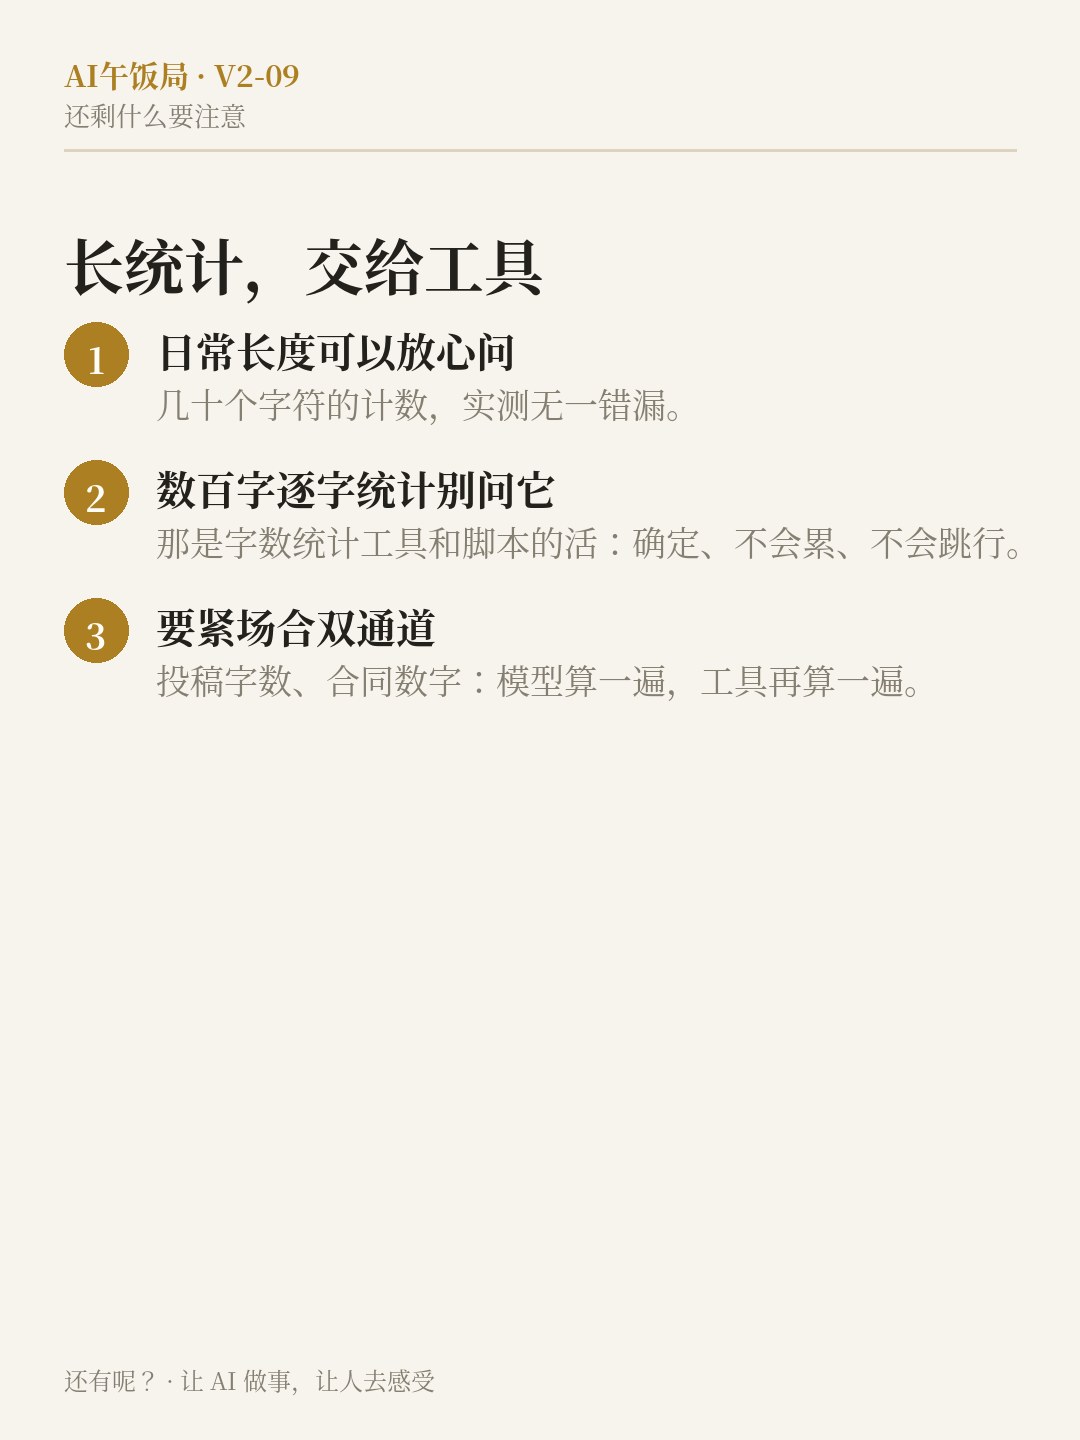
第一,更长的逐字统计没测,也不该指望它。 数百字、上千字的文本里某个字出现多少次,这种活的正确答案应该来自字数统计工具或一段脚本——它们是确定性的、不会累、不会跳行。让模型做这件事,即使它这次答对,你也无法验证它下次对不对。这是工具分工问题,不是信任问题。
第二,要紧场合双通道核对。 投稿字数、合同里的数字、表格里的合计——凡是错了要付出代价的计数,用两种独立方法各算一遍,模型算一遍、工具算一遍,对上了再用。本刊每一期实测其实都在说同一句话:知道它的能力边界在哪里,比知道它「行」或「不行」有用得多。
边界
样本为 3 个会话 × 11 道题(两轮合计 33 题次),执行模型 Muse Spark;文本长度在 60 字符量级以内,未测数百字级逐字统计;会话被要求不使用代码工具,其内部过程不可独立验证;真值全部由程序计算。
来源 分词与「草莓问题」:BPE 分词机制与模型「只见词元不见字母」的公开技术解说(2024–2026 多篇,经检索转述)。 实测:本栏目实测,3 个独立会话 × 两轮共 11 道计数题(执行模型 Muse Spark,2026-11-04),题目、真值与判分脚本见本期实验档案。