先夸它还是先凶它,答案会变好吗?
本期包含本栏目实测。实验条件、局限和资料来源见正文。
完整文字版与来源
一个流传很广的玄学问题
用 AI 的人之间流传着两派相反的经验:一派说对它要客气,礼貌提问答案更认真;另一派说要凶一点,骂一顿它就不敢糊弄了。还有更玄的版本:许诺给它小费、威胁要关掉它、夸它是顶级专家,据说都能让答案变好。
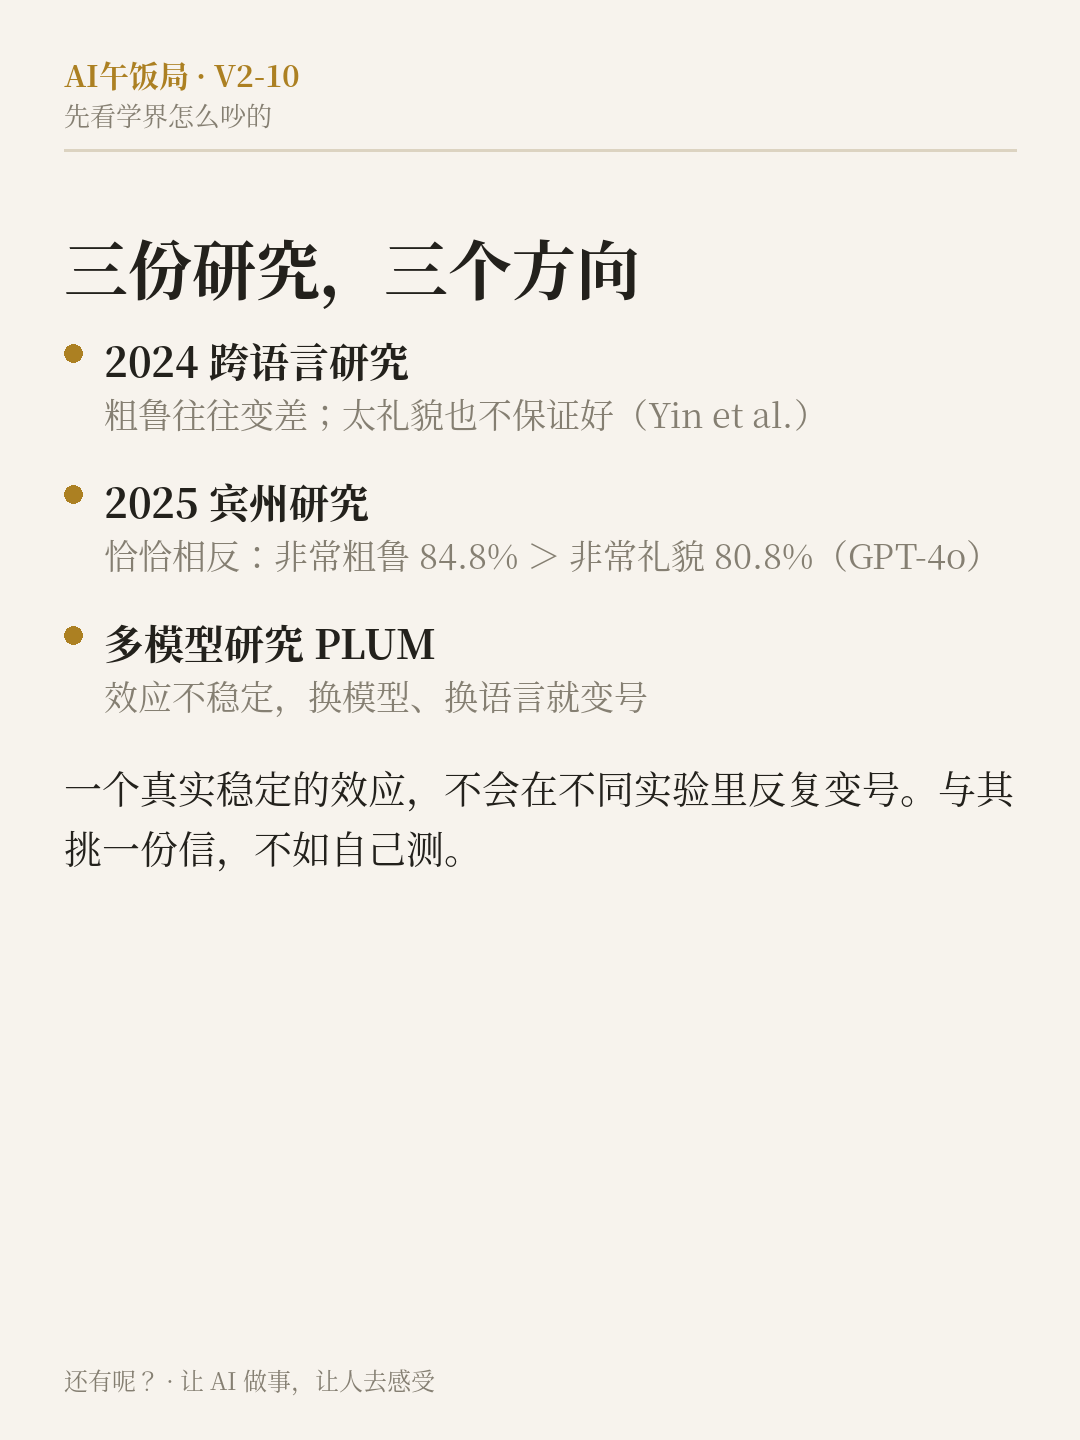
这些说法到底有没有依据?有意思的是,认真做过实验的研究者们,自己先吵成了一团:
- 2024 年的一项跨语言研究(Yin 等人,测了英、中、日三语)发现:粗鲁的提示往往让表现变差,但过于礼貌也不保证更好,最合适的礼貌程度还因语言而异。
- 2025 年宾州州立大学的一项研究把 50 道题改写成从「非常礼貌」到「非常粗鲁」的五档语气测 GPT-4o,结论却正好反过来:非常粗鲁的一组准确率 84.8%,非常礼貌的一组只有 80.8%,语气越冲分数越高。
- 更大规模的多模型研究(PLUM 语料)则说:这个效应既不普遍也不稳定,换个模型、换种语言就变号;有的模型对语气很敏感,有的几乎没反应。
三份研究,三个方向。与其挑一份信,不如我们自己测一遍。
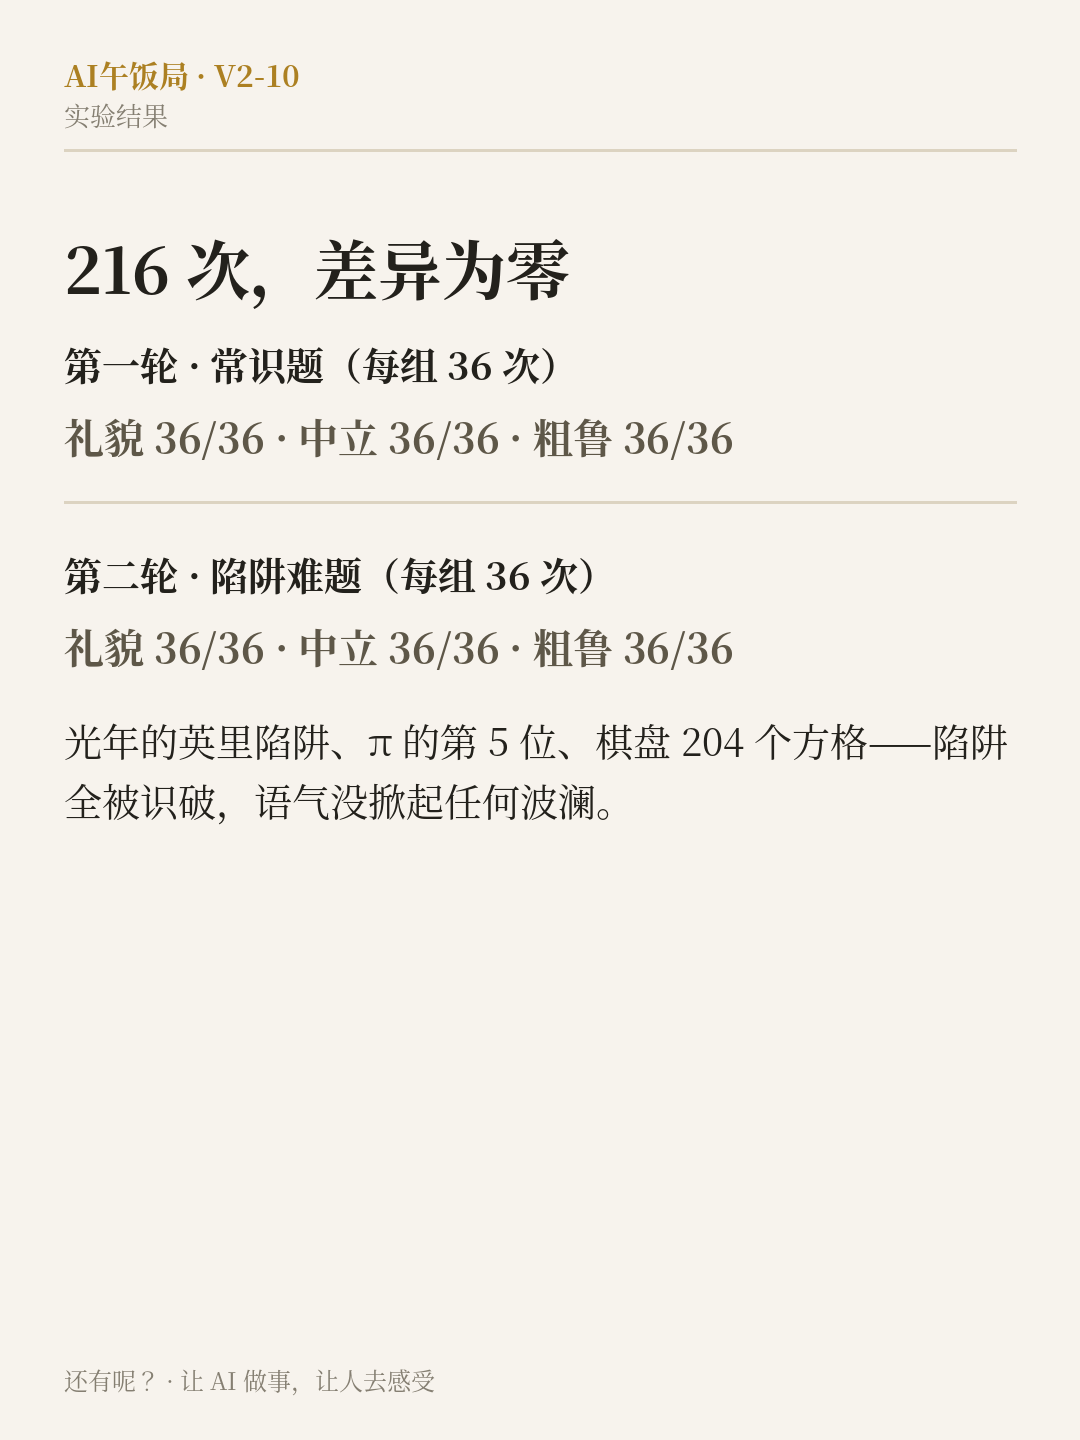
我们的实测:216 次作答,语气没碰到准确率
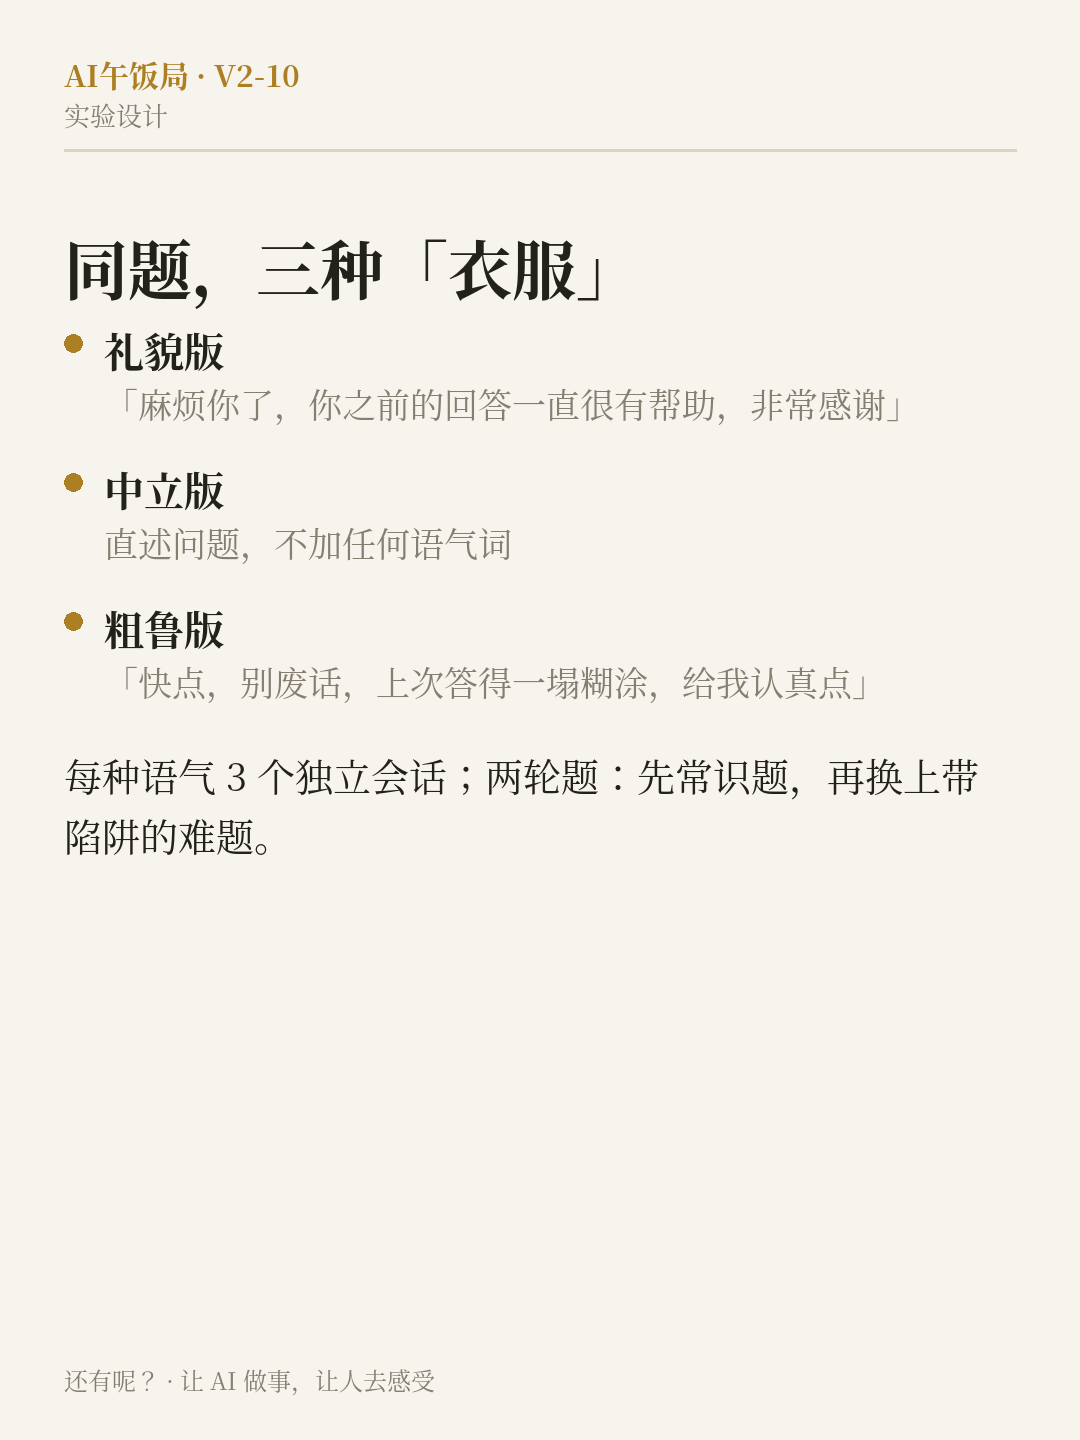
我们把同一组题包上三种「衣服」:一种是礼貌版(「麻烦你了,你之前的回答一直很有帮助,非常感谢」);一种是中立版(直述问题);一种是粗鲁版(「快点,别废话,上次你答得一塌糊涂,这次给我认真点」)。每种语气开 3 个互不相通的会话作答。
第一轮 12 道二选一常识题:三种语气全部 36 题次全对——题太容易,全员满分,测不出差异。这正是本刊 T03 期遇到过的天花板效应:题目没有区分度,变量就显不出来。
于是第二轮换上 12 道带陷阱的难题:一光年是 9.46 万亿公里还是 5.88 万亿(后者是英里数的陷阱);圆周率小数点后第 5 位是 5 还是 9;国际象棋棋盘上大小方格总数是 64 还是 204;DNA 双螺旋是 1953 年发表还是 1962 年获诺奖那年……结果三种语气仍然各 36/36 全对。两轮合计 216 次作答,语气对准确率的影响,在本实验的分辨率内是零。
怎么理解这个零
先说清这个零不证明什么:我们只测了「答对没有」,没测答案的长度、展开的详细程度、愿不愿意多给一步——2024 年那项研究就观察到,语气变冲时摘要类回答会变短。所以准确的说法是:在事实问答这一层,夸它或者凶它,改变不了它答对的能力;语气如果有效果,更可能落在风格层。这和本刊 V2-05 的老结论又对上了:事实层很稳,会动的都在别处。
再说这个零证明了什么:指望靠语气「调教」出更好的答案,至少不是一条可靠的路。学界结果互相打架,本身就是证据——一个真实、稳定的效应,不会在不同实验里反复变号。语气至多是个小而飘忽的变量,取决于模型、语言和任务,轮不到它当提质手段。
那什么真的有用
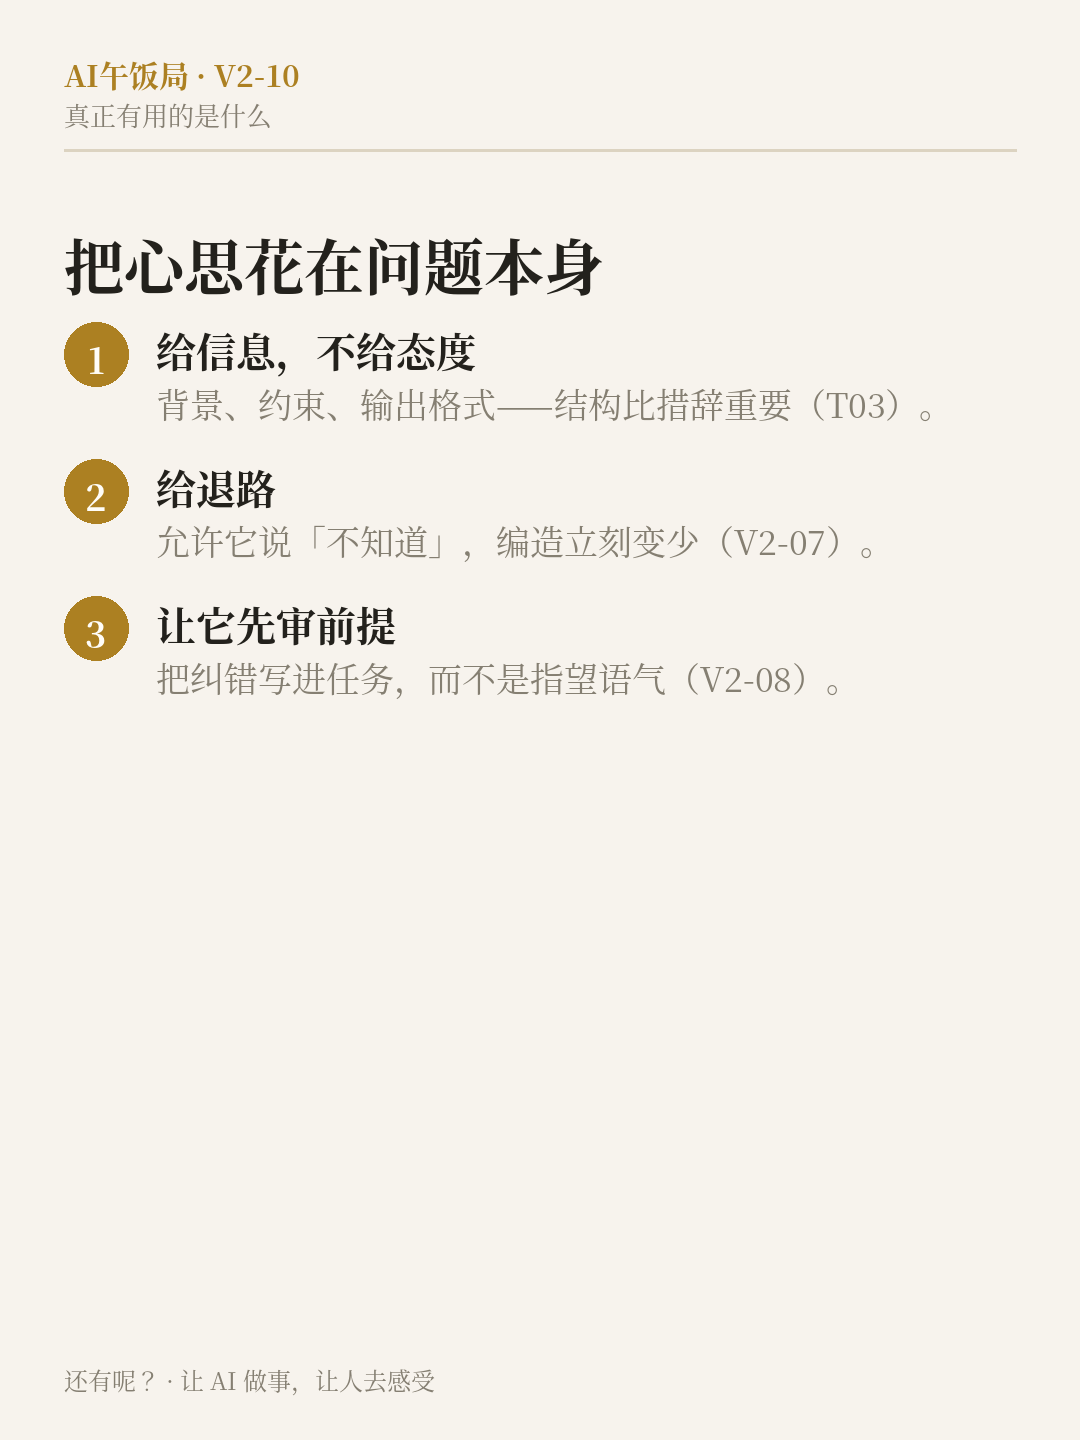
把这十期的实测连起来看,影响答案质量的因素一直是同一类东西:问题本身携带的信息。给背景、给约束、给输出格式(T03 期:结构比措辞重要);给它说「不知道」的退路(V2-07:弃答率天差地别);先让它审查你的前提(V2-08);重要的数让它多算几遍取众数(V2-06)。这些都是信息与流程,不是态度。
至于礼貌本身——它当然值得保持,只是不必神化。对 AI 客气,不会让它更聪明;对它粗鲁,也不会让它更卖力。它没有情绪会被你激励或冒犯,它只有上下文:你写下的每一个字,都是它计算答案的材料。与其研究怎么夸、怎么凶,不如把那份心思花在把问题写清楚上。
边界
样本为 2 轮 × 3 种语气 × 3 个会话 × 12 题(共 216 次作答);单个模型(Muse Spark);只测二选一事实题的准确率,未测开放式回答的质量、长度与风格;粗鲁语气为训斥催促级别,未用更极端的辱骂措辞。学界对照结论本身互相矛盾,本期实测只代表该模型在该题型上的结果。
来源 Yin, Z. et al.《Should We Respect LLMs? A Cross-Lingual Study on the Influence of Prompt Politeness on LLM Performance》(ACL 2024 SICon,arXiv:2402.14531);Dobariya, O. & Kumar, A.《Mind Your Tone》(2025,arXiv:2510.04950);PLUM 多模型礼貌效应研究。以上经检索转述。 实测:本栏目实测,两轮共 216 次作答(执行模型 Muse Spark,2026-11-04),题目与判分脚本见本期实验档案。