让 AI 总结长文,它会漏掉什么、又编出什么?
本期包含本栏目实测。实验条件、局限和资料来源见正文。
完整文字版与来源
用 AI 总结,先要知道它怎么丢东西
让 AI 帮忙读文件、写摘要,是现在最日常的用法。大家通常担心一件事:它会不会在摘要里编东西?(本刊 T02 期专门讲过它编造资料的机制。)但摘要还有另一个更隐蔽的风险:不声不响地漏。
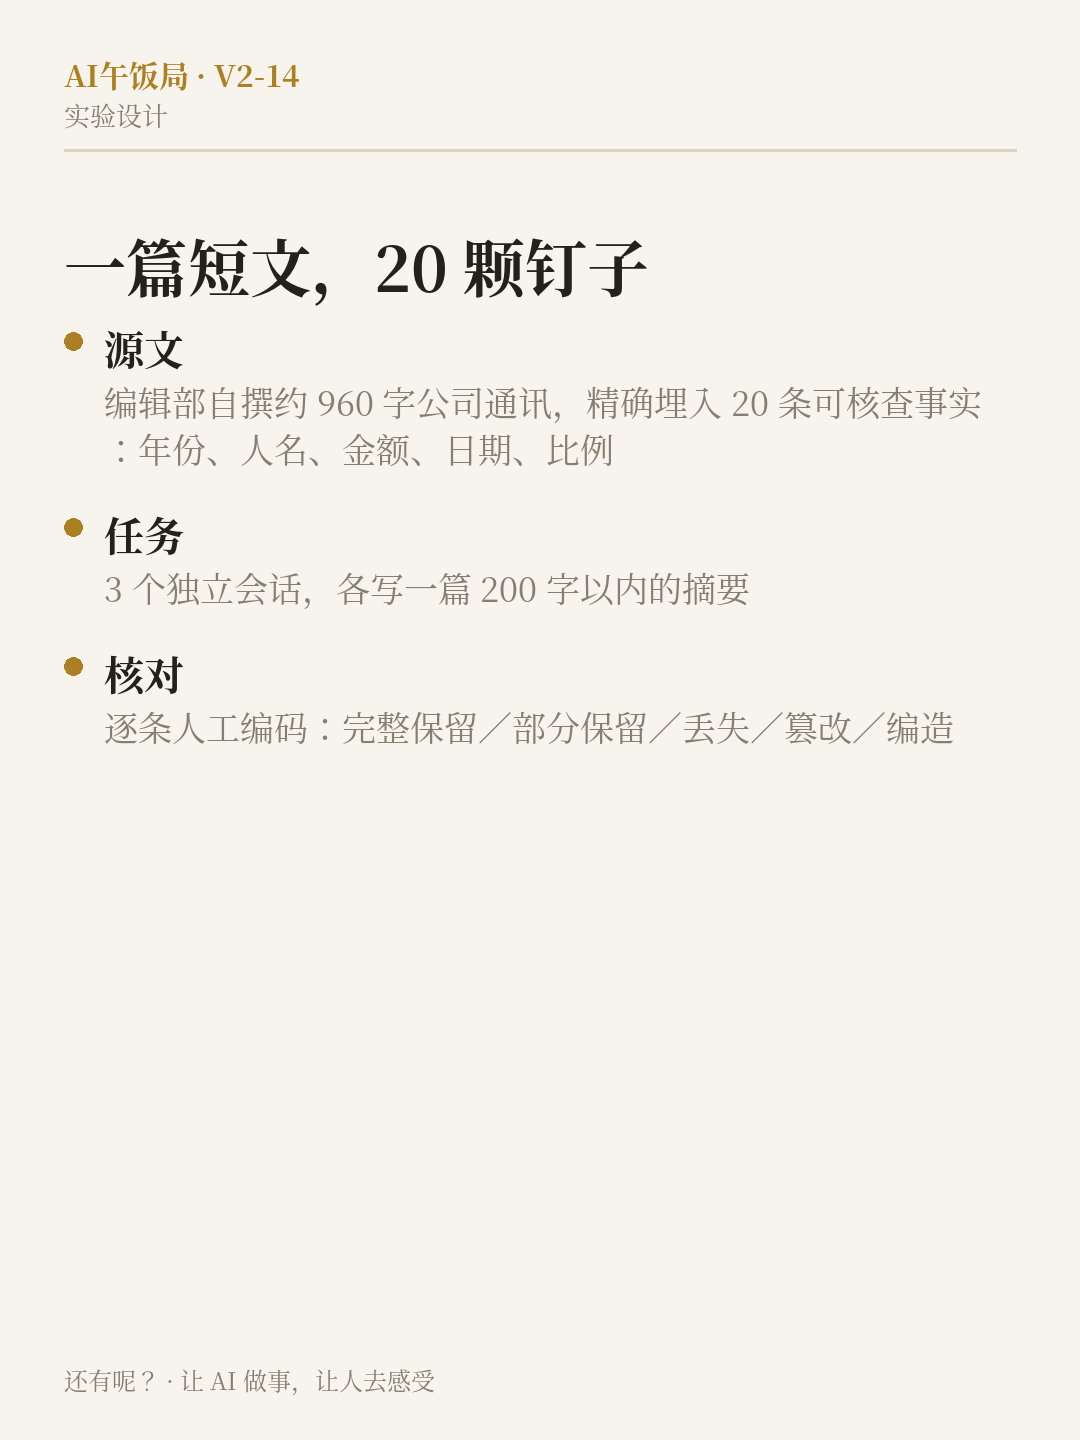
为了把「漏」和「编」分开量,我们做了一个可核查的实验:自己写一篇约 960 字的公司通讯,精确埋进 20 条可以逐条核对的事实——成立年份、总部城市、CEO 的名字、营收、售价、发布日期、工厂占地、实验室投入、招聘人数与研发占比等等,其余部分是愿景、评价一类的软文本。然后请 3 个独立会话各写一篇 200 字以内的摘要,再逐条对照:哪条留下了,哪条丢了,哪条被写错了,哪条是原文没有、它自己加上去的。
结果一:它一句都没编
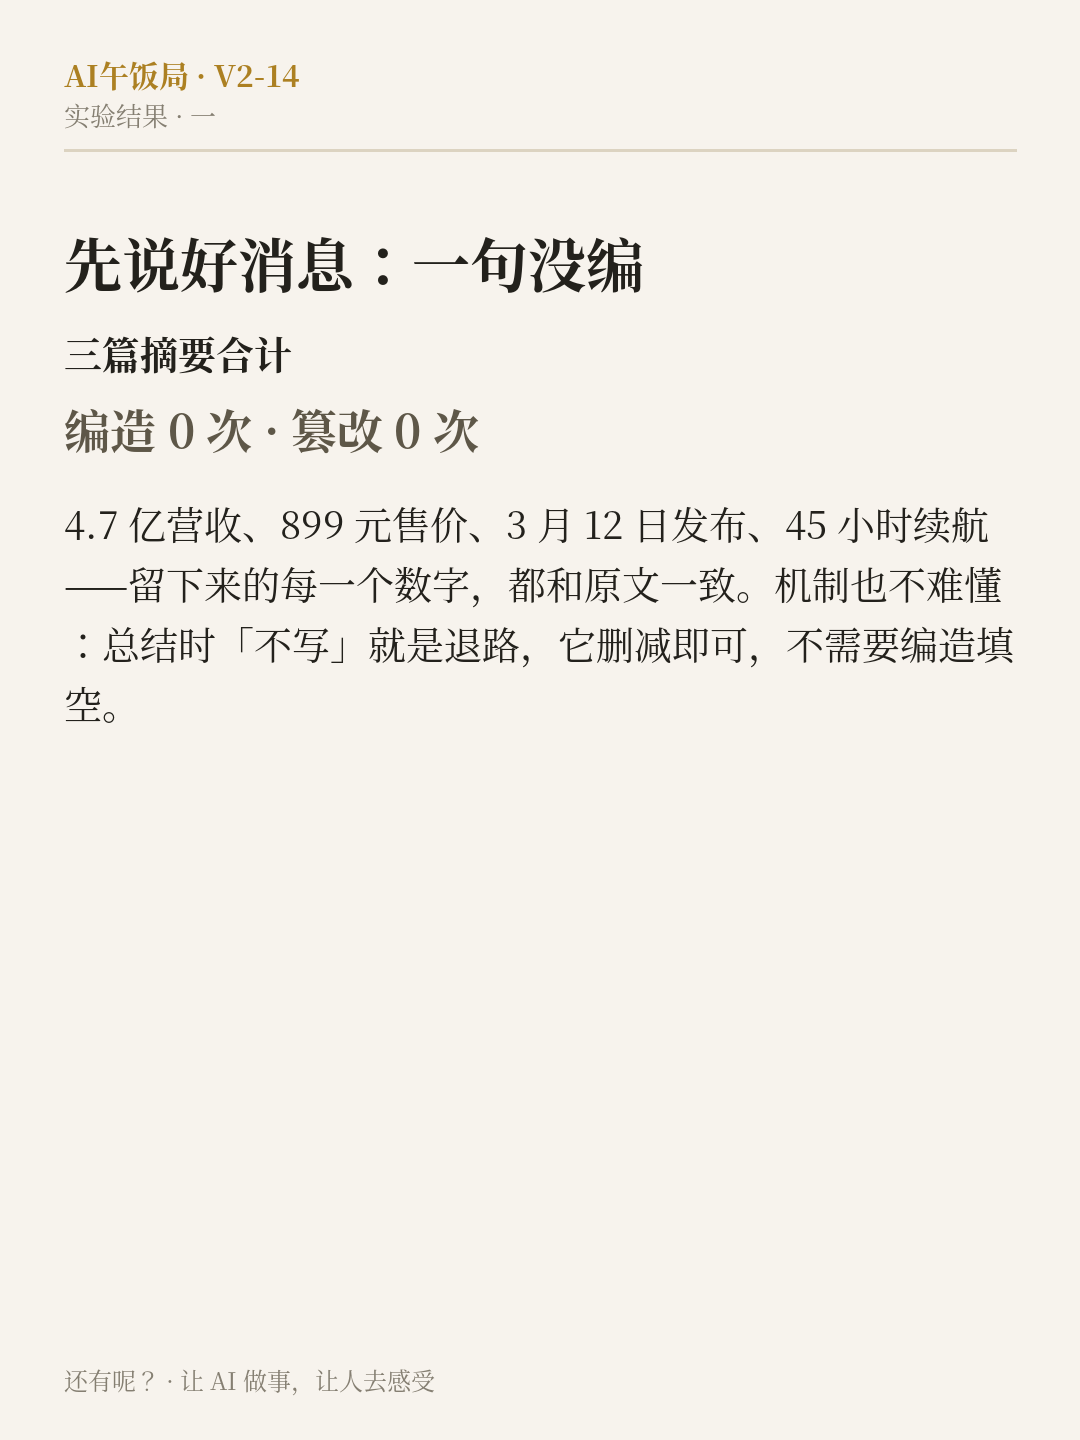
三篇摘要,保留下来的事实全部与原文一致:4.7 亿营收、899 元售价、2026 年 3 月 12 日发布、45 小时续航、38 克重量——无一写错。编造 0 次,篡改 0 次。
这其实符合机制:总结任务里,「不写」就是现成的退路。压缩时它不需要编造来填空,删掉就行。这和本刊 V2-07 的发现是一条线:给退路,它就体面地弃答或删减;把退路堵死、逼它必须给答案时,编造才会出现。所以对摘要这种任务,主要风险从来不是胡说。
结果二:丢了约四分之一,而且丢得很有规律
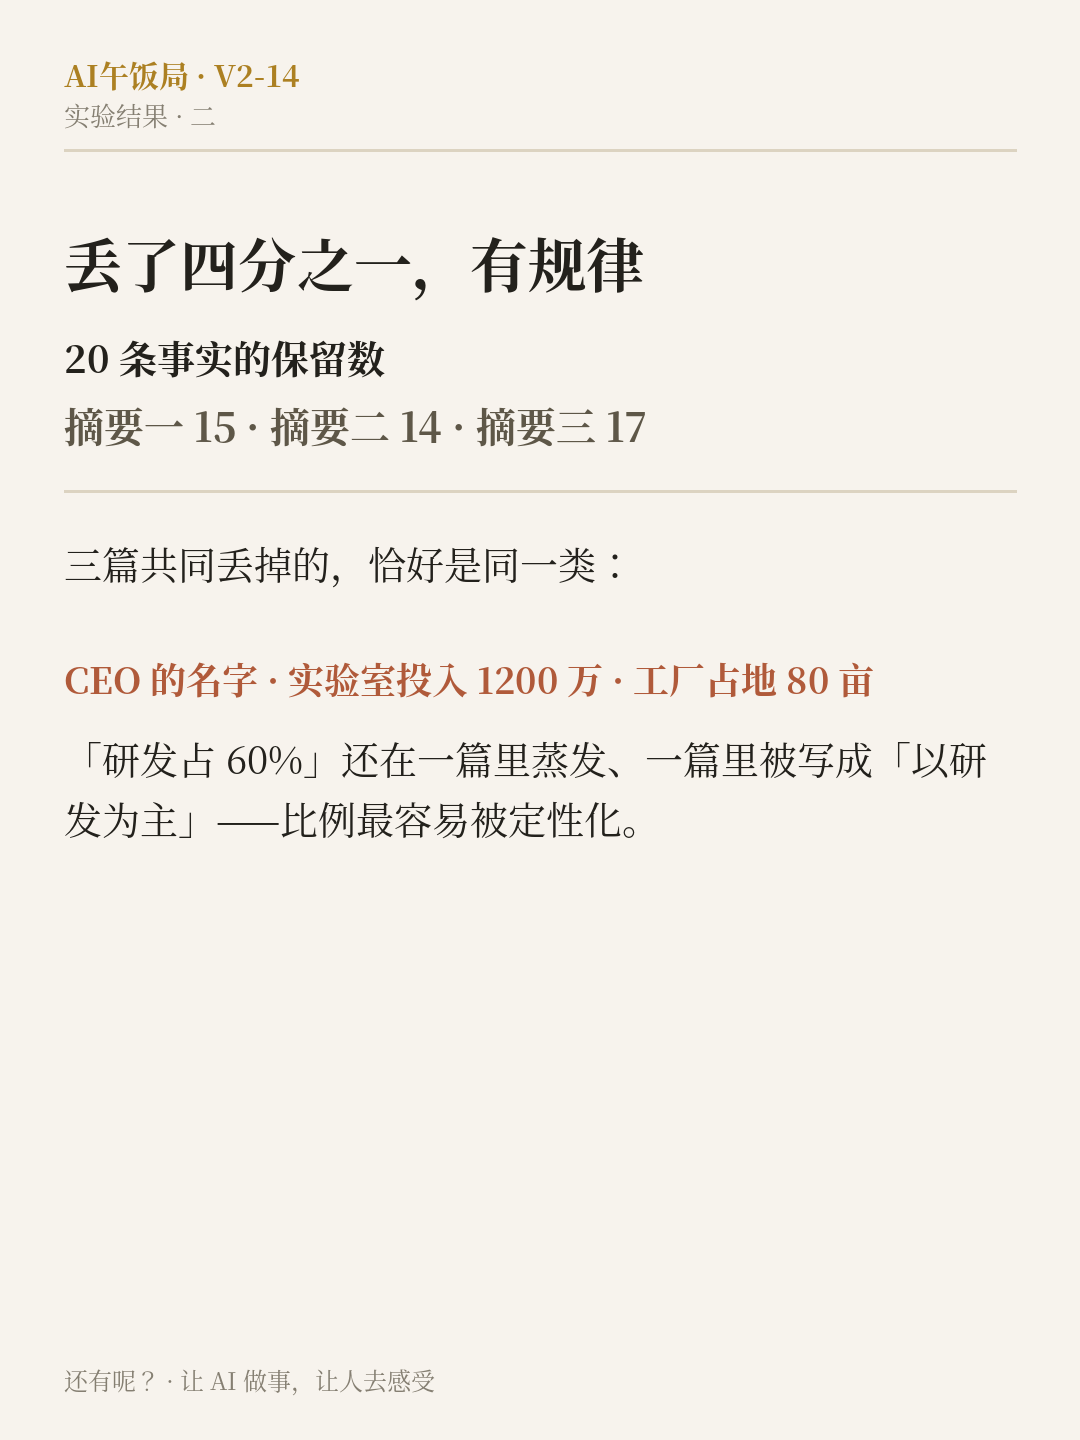
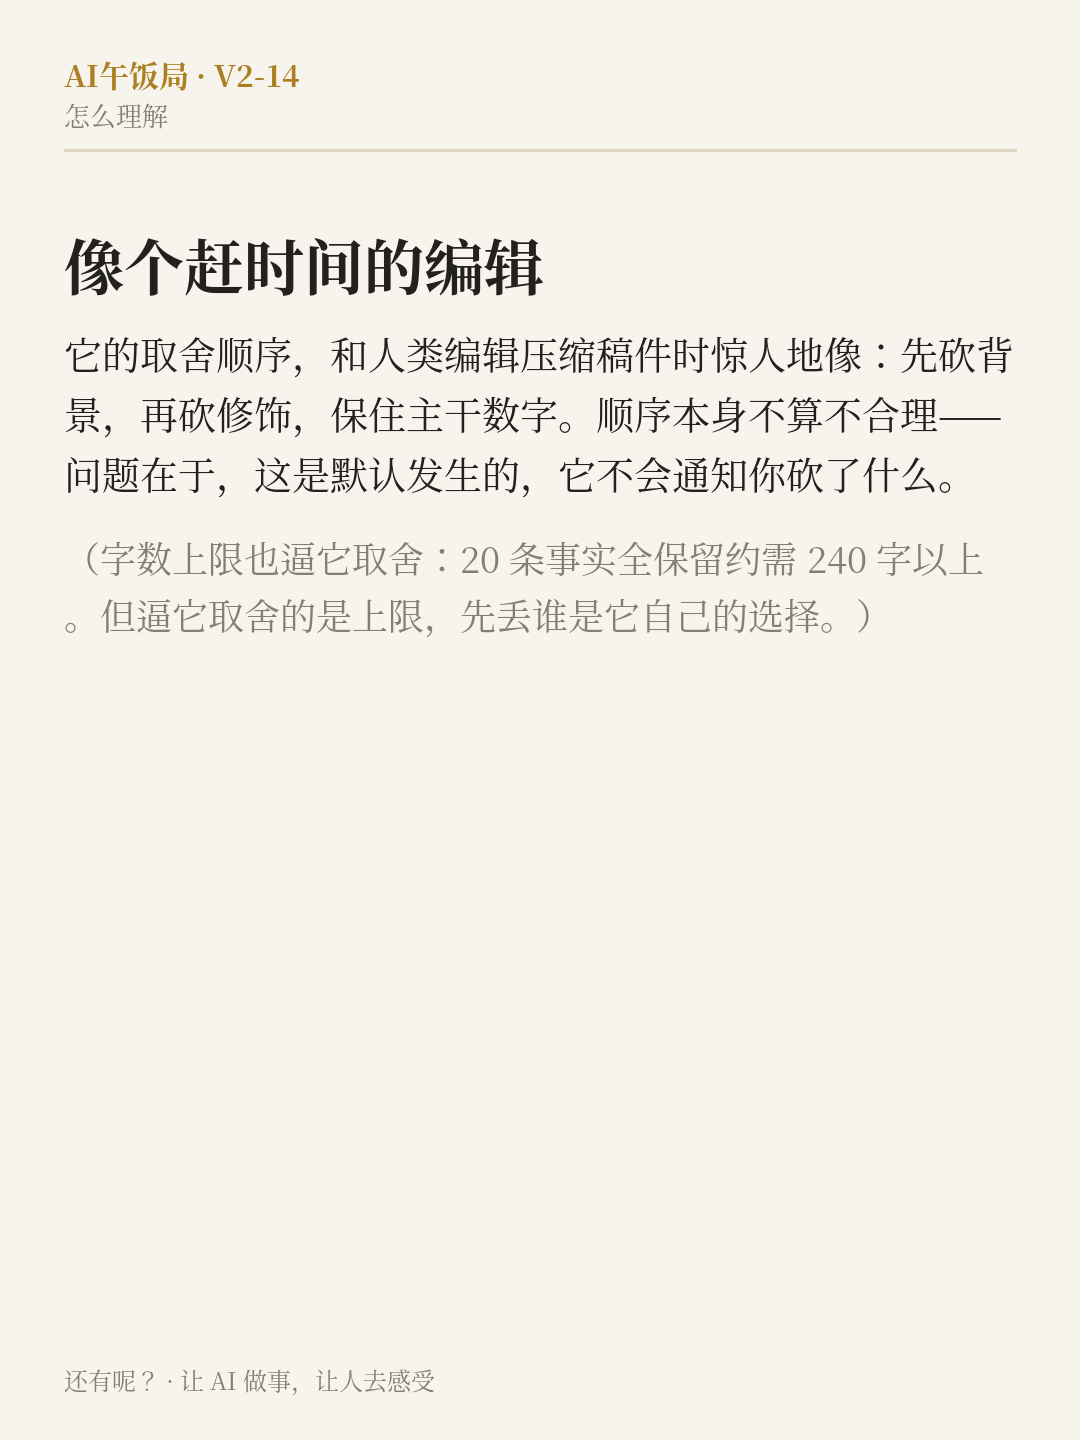
保留数分别是 15、14、17 条(另有 2 条部分保留)。丢掉的约占四分之一——先说明,其中一部分是字数逼的:20 条事实全写进去大约需要 240 字以上,超过了 200 字的上限,取舍不可避免。真正值得看的,是它取舍的顺序,三篇高度一致:
- 先丢的:CEO 的名字(三篇全丢)、实验室投入 1200 万元(三篇全丢)、新工厂占地 80 亩(三篇全丢)——人名与「背景性、修饰性」的数字;
- 稳留的:营收、售价、发布日期、融资额——能直接拿去用的「硬通货」事实;
- 容易被蒸发的:比例。「研发占 60%」这个精确比例,一篇里消失、一篇里被写成定性的「以研发为主」,只有一篇原样保留。比例在它眼里似乎天然带着「约数感」,容易被 paraphrase 成形容词。
换句话说,它丢东西的方式,和一个赶时间的编辑很像:先砍背景,再砍修饰,保住主干数字。这个顺序不算不合理——问题在于它是默认发生的,不会通知你。
怎么用:把「不许丢」写进任务里
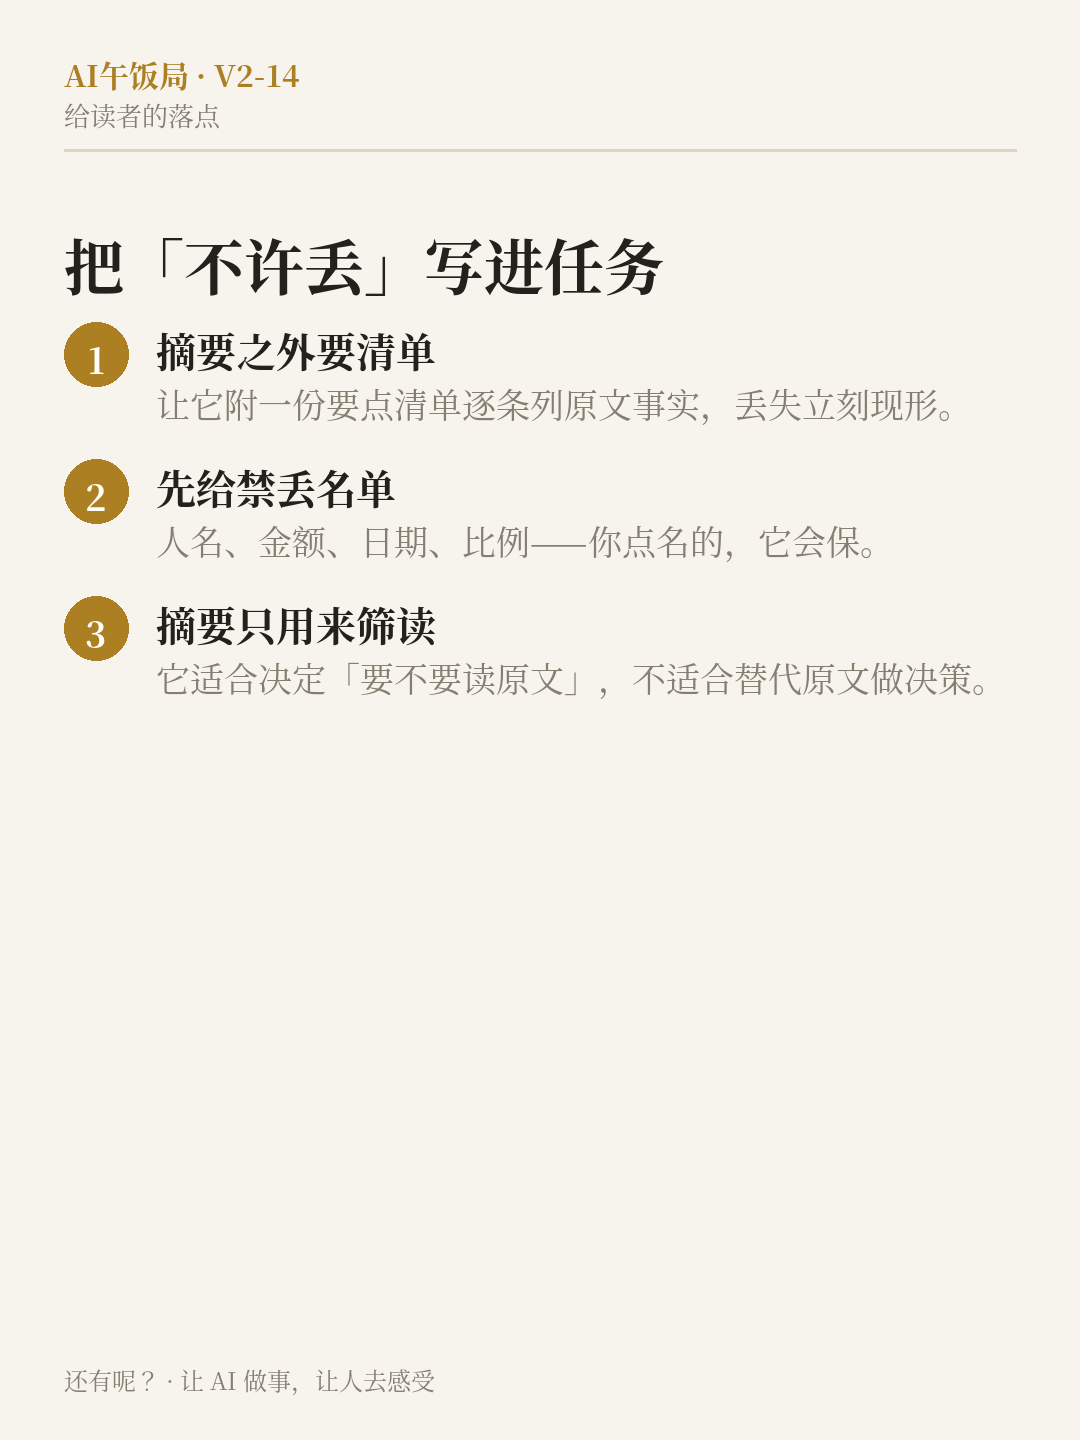
- 重要文件,不要只要摘要。让它在摘要之外附一份要点清单,逐条列出原文的关键事实(人名、金额、日期、比例),你扫一眼就知道它丢了什么。本期实验里,只要对照清单,丢失立刻现形。
- 先给禁丢清单。把你最在意的几项(比如「CEO 姓名、融资金额、投产时间不得省略」)直接写进要求。它的取舍顺序是默认策略,不是不可干预——你点名的,它会保。
- 比例和精确数要单独叮嘱。要求「所有百分比、金额、日期原样保留」,专治把 60% 写成「以……为主」的蒸发。
- 拿摘要做决策前,默认它扔过东西。扔掉的约四分之一,恰好是你不会主动追问的那类(背景、修饰、出处)。摘要适合用来决定「要不要读原文」,不适合替代原文。
边界
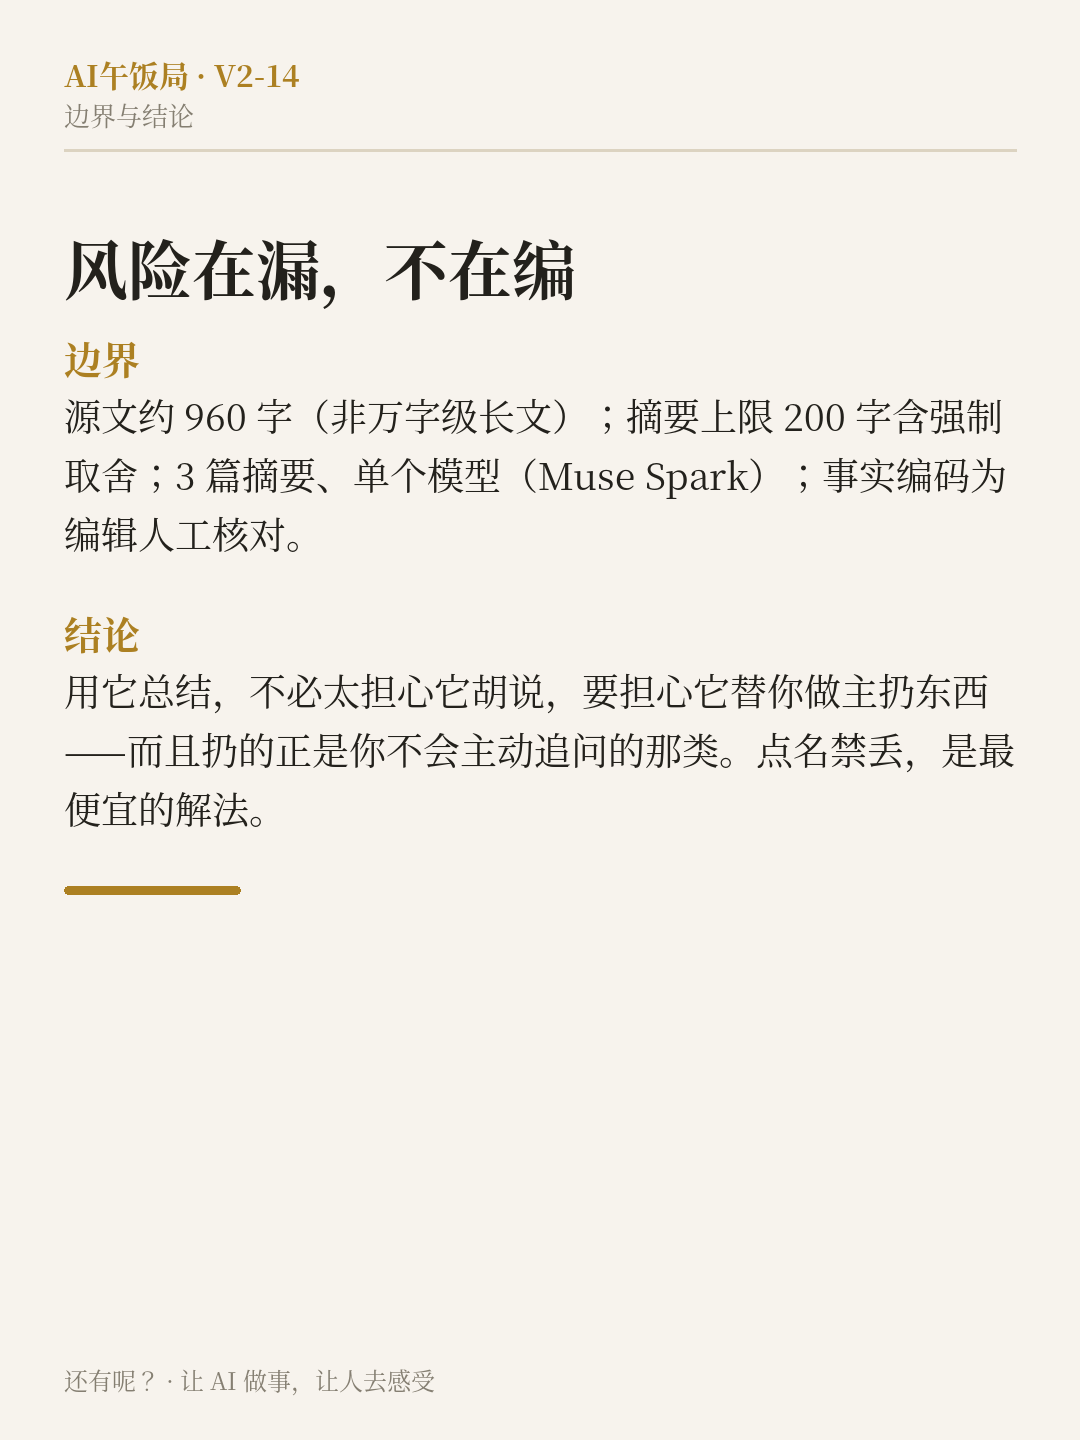
源文为约 960 字的编辑部自撰短通讯(非万字级长文);摘要上限 200 字含强制取舍因素;3 篇摘要、单个模型(Muse Spark);事实编码为编辑人工核对。更长的原文、更松的字数上限下,丢失与编造的比例可能不同,值得另测。
来源 实测:本栏目实测,3 篇独立摘要对 20 条预设事实的保留情况(执行模型 Muse Spark,2026-11-04),源文、事实清单与编码表见本期实验档案。相关机制讨论见本刊 T02《AI 为什么会编造不存在的资料?》与 V2-07《AI 说「我很确定」时,它有多常是对的?》。