同一张表,换个格式它就读不懂了?
本期包含本栏目实测。实验条件、局限和资料来源见正文。
完整文字版与来源
一个流传很广的喂数据焦虑
把数据喂给 AI 时,很多人有格式焦虑:表格要不要转成 Markdown?CSV 它读得顺吗?写成一段话它会不会就找不到数了?网上的经验帖各执一词,还有人专门总结「黄金格式」。
这类争论有个共同问题:很少有人拿同一份数据、同一个问题,正经八百地比过。我们比了,而且比了两轮。
第一轮:四种格式,全对
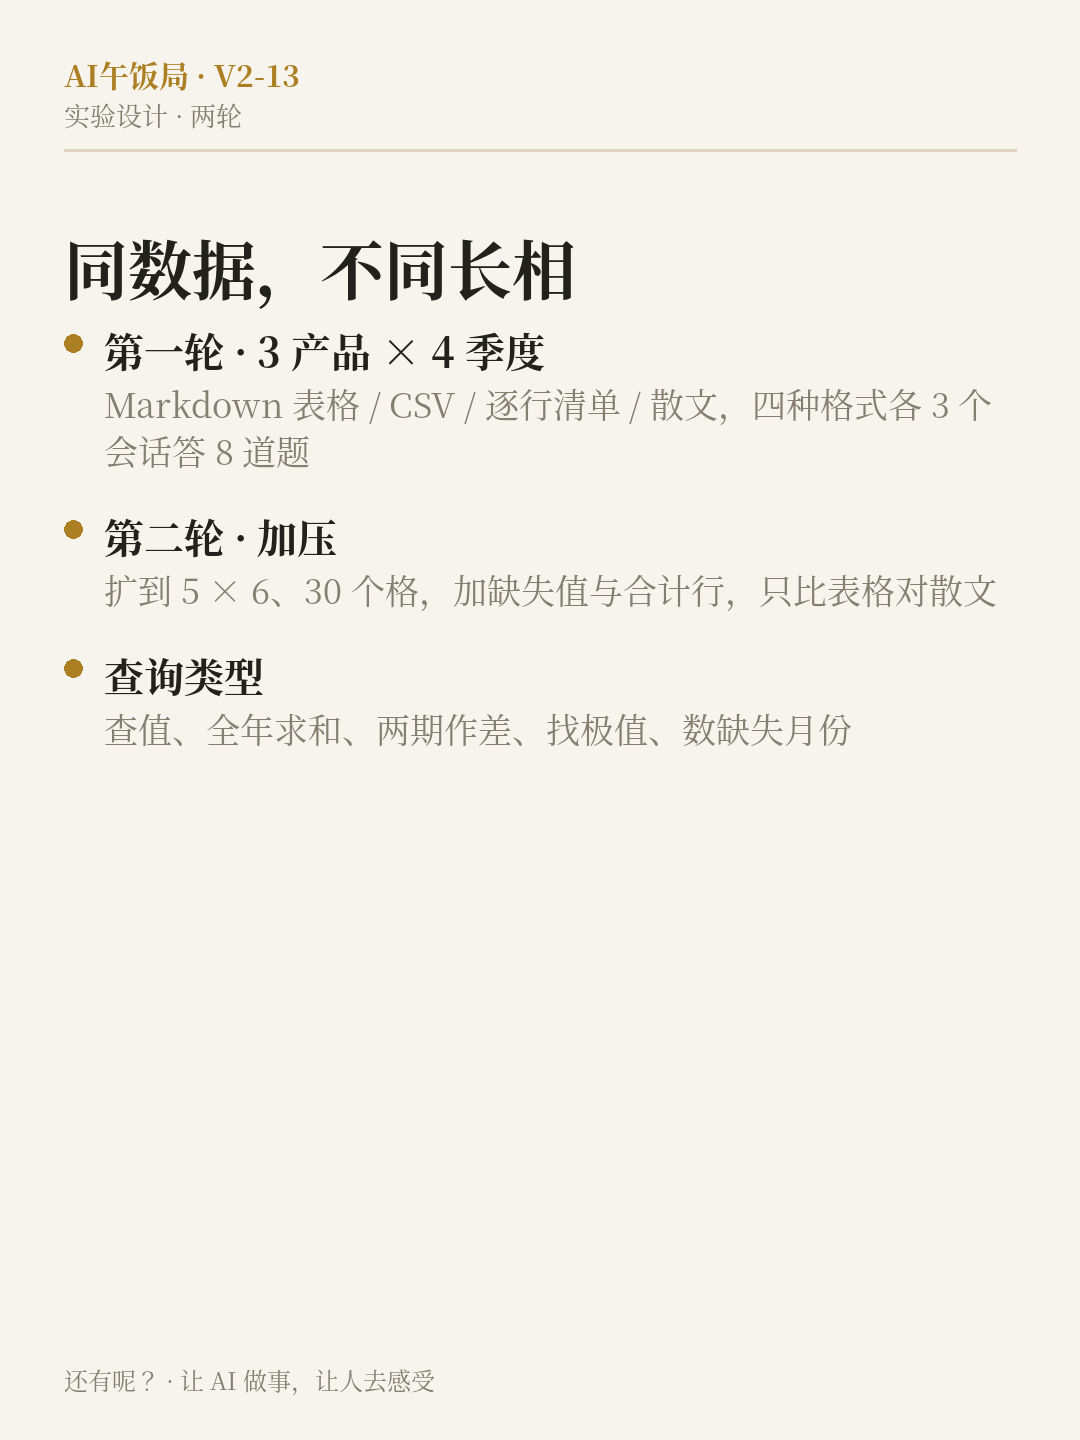
我们编了一家小公司的销售表:3 个产品、4 个季度、12 个销售额。同一份数据做成四种样子——标准的 Markdown 表格、逗号分隔的 CSV、逐行列出的文本清单、以及一段完全散文化的叙述(「云朵杯第一季度卖了 128 万元,第二季度 156 万元……」)。
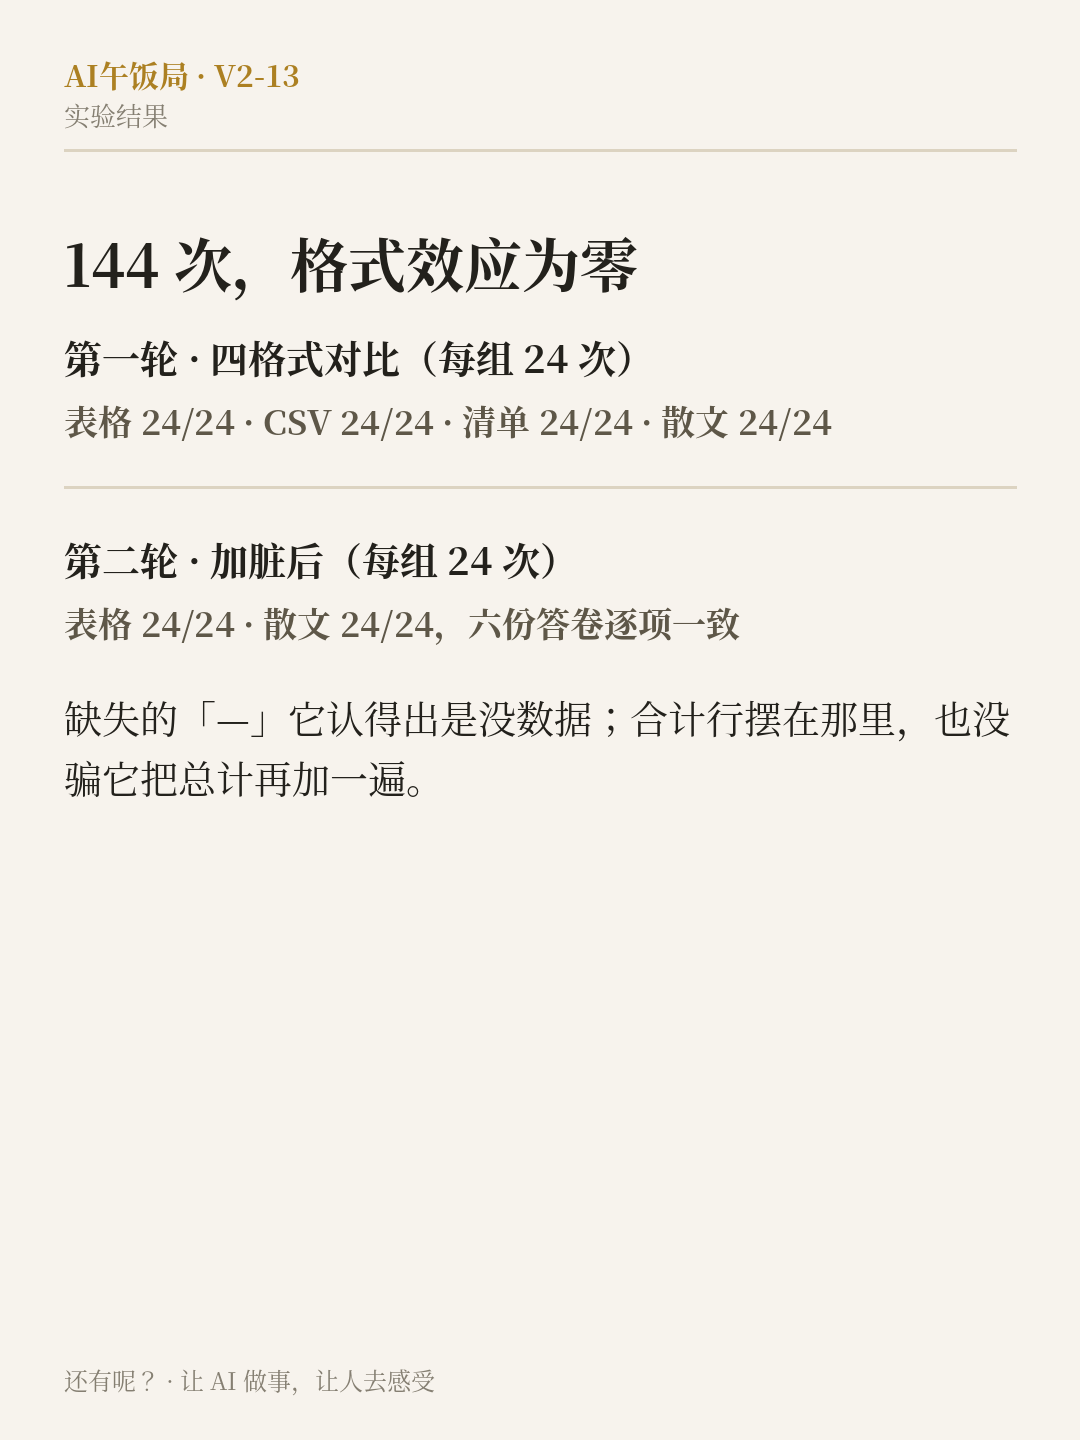
每种格式交给 3 个独立会话,回答同一组 8 道题:查某个格子、全年求和、两季度作差、找合计最高的季度。结果:四种格式全部 24/24。合计 96 次查询,零错误。
第二轮:加脏,表格对散文,还是全对
第一轮的表太小太干净。我们加压:扩到 5 个产品、6 个月、30 个格子,再塞进两个现实里最常见的麻烦——一个缺失值(星月灯 3 月未上市,表格里是「—」),一行合计(合计行是经典陷阱:不小心会把总计当成一个产品再加一遍)。只比最悬殊的两种:Markdown 表格对纯散文。
8 道题包括:跨六个月求和、全店总销售额(3671 万元)、数缺失的月份、找单产品最高。结果:两种格式又都是 24/24,六份答卷逐项一字不差。散文里我们甚至写了一句带倾向的话——「星月灯是卖得最好的」——需要计算的题目照样没被这句叙述带偏。
怎么理解
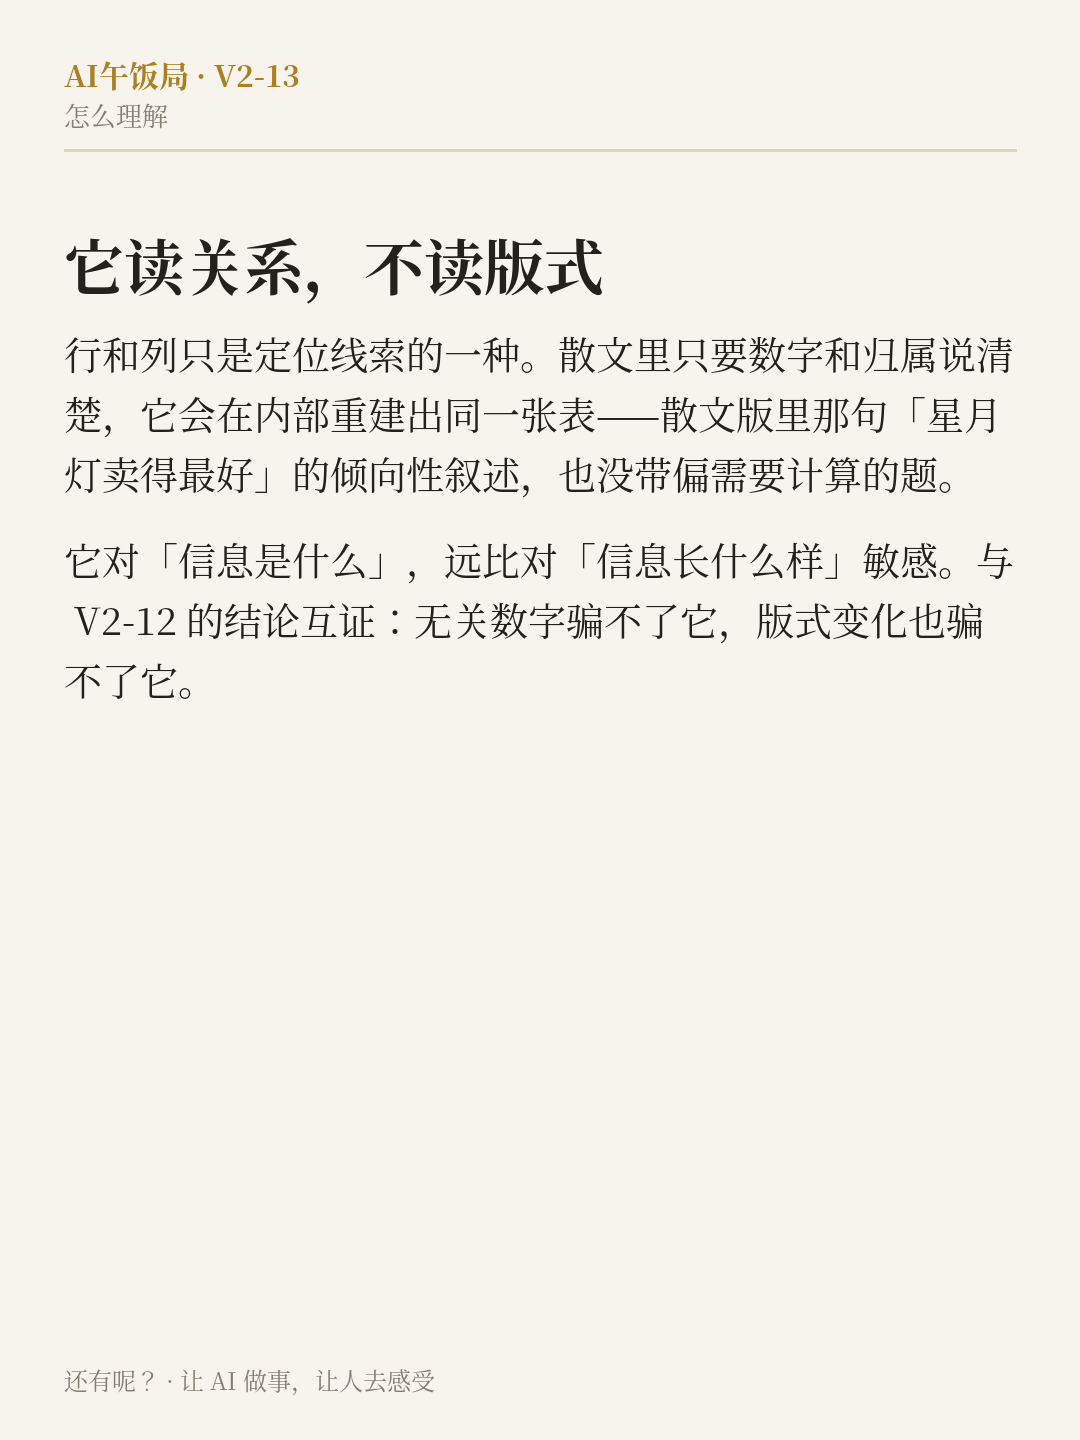
在这个量级上,可以成立的结论是:它读的是数据关系,不是版式。行和列对它来说只是定位线索的一种,散文里只要数字和归属说清楚,它重建出同一张内在的表。而且缺失值它处理得对(知道「—」是没数据、不是零,也不是要跳过的行),合计行也没有骗它重复计算。
这与最近几期的实测互相印证:V2-12 里无关数字骗不了它做应用题,这里版式变化骗不了它读表——它对「信息是什么」远比对「信息长什么样」敏感。
边界与落点
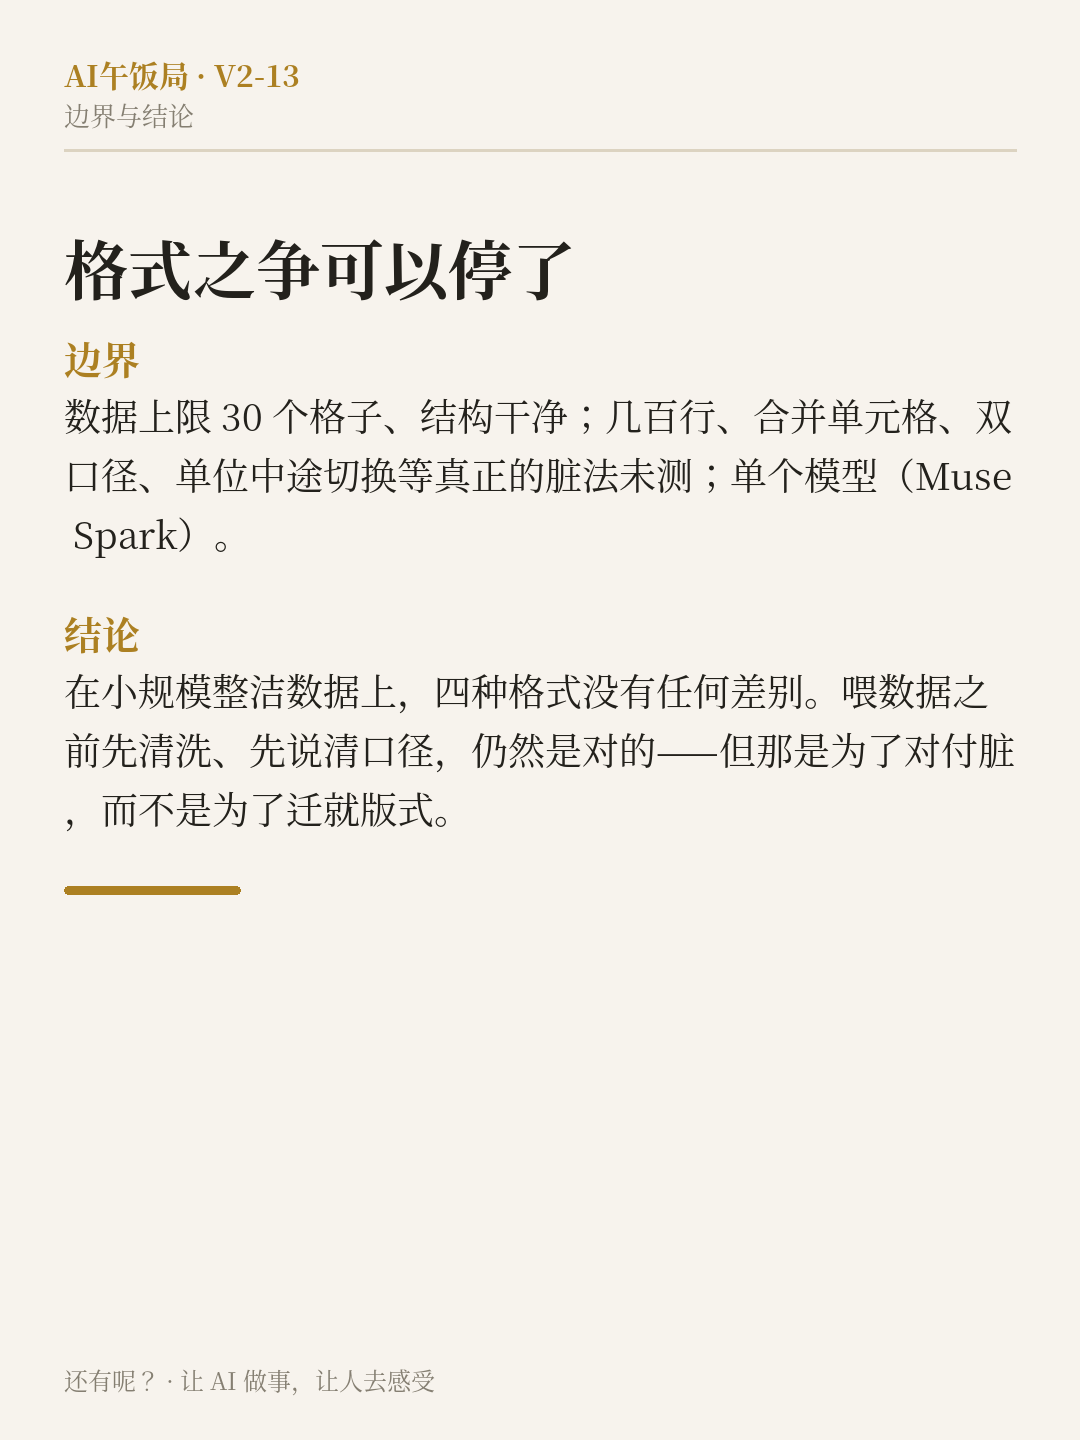
没测的部分要讲明:真实工作里的表常常有几百行、合并单元格、同一个指标前后两种口径、单位在表格中间悄悄切换。这些「脏」法本期都没上,结论只覆盖「小规模、结构干净」的数据。在这个前提下,给读者的落点很简单:
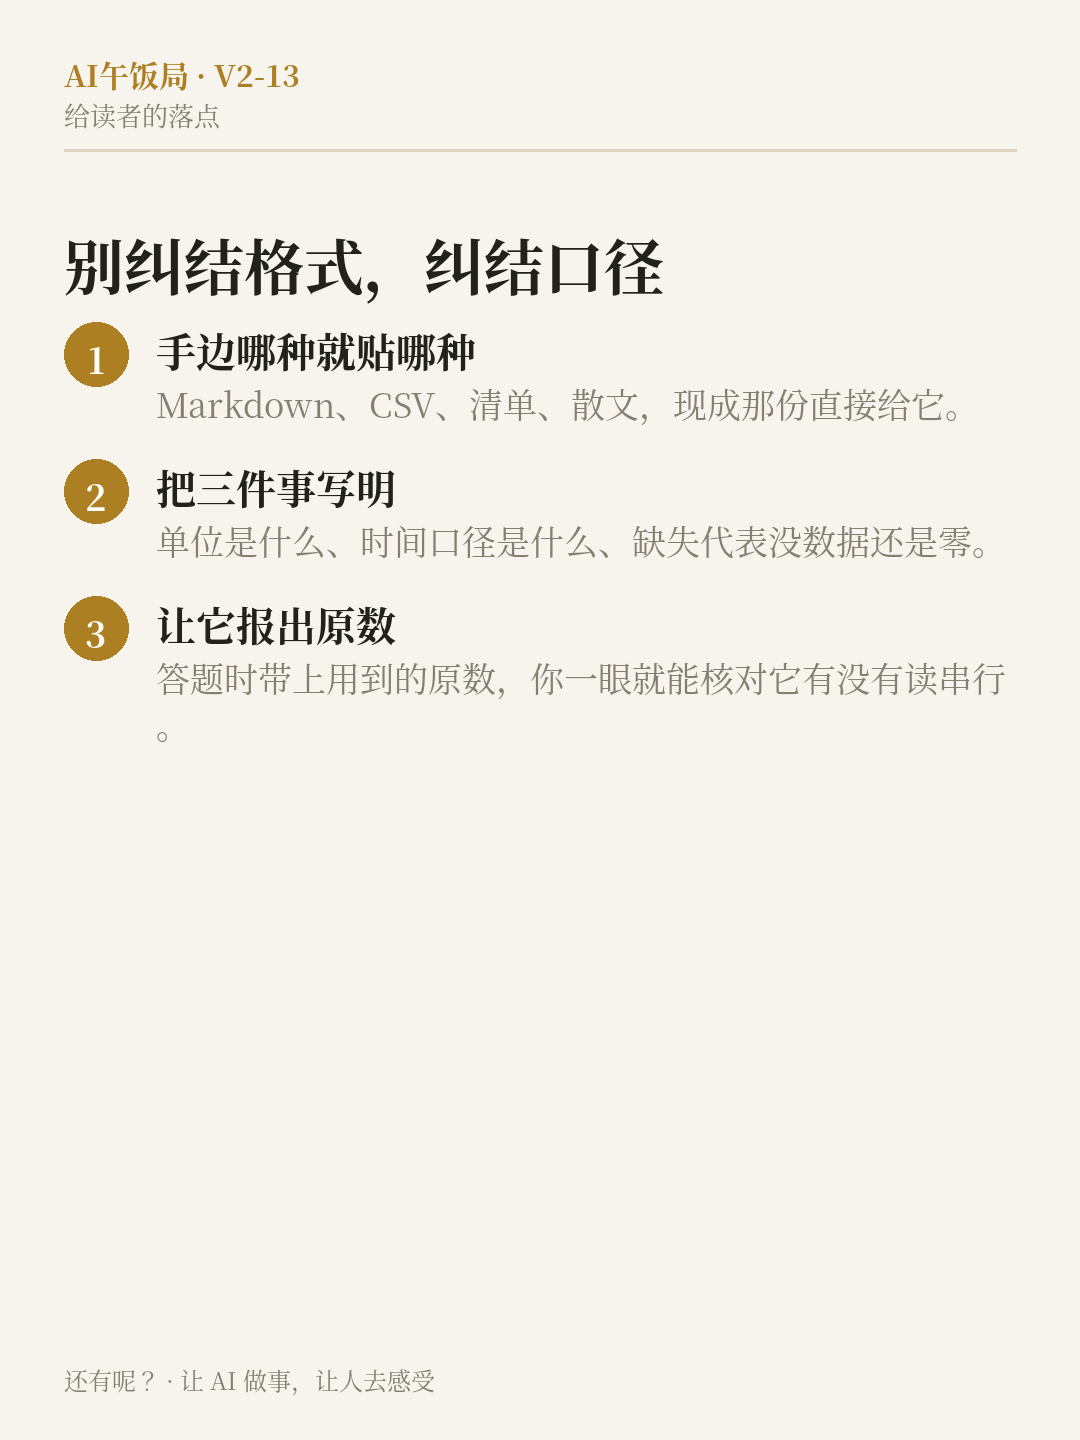
- 别在格式上耗时间。Markdown、CSV、清单、散文,它都读得一样好;把你手边现成的那份直接给它。
- 把时间花在把数字说清楚上:单位是什么、时间口径是什么、缺失值代表没数据还是零。这三件事写明,比任何「黄金格式」都管用。
- 重要的表,让它回答时顺带报出用到的原数(「星月灯 Q3 是 226」),你一核对就知道它有没有读串行——这一招比换格式实在得多。
边界(汇总)
数据规模上限为 30 个格子;数值均为整数、无单位混杂与合并单元格;单个模型(Muse Spark);两轮共 144 次查询。
来源 实测:本栏目实测,两轮共 144 次查询(执行模型 Muse Spark,2026-11-04),数据、题面与判分脚本见本期实验档案。关于「格式效应主要出现在大而脏的表格上」为编辑综合判断,非单一论文结论。