AI 为什么会编造不存在的资料?
本期内容均为(附来源),编辑类比与判断均已单独标注;本期无本栏目实测内容。
完整文字版与来源
开场:它不是在撒谎
先说清一个区别:撒谎的人知道真相是什么,只是故意不说。AI 编造资料时,脑子里并没有一份「真相」被它藏起来——它从头到尾就没打算分真假。理解这一点,才算理解了「幻觉」这个词。
下面这个真实案件,是这件事最贵的学费。
一、一位律师,和 6 个不存在的判例
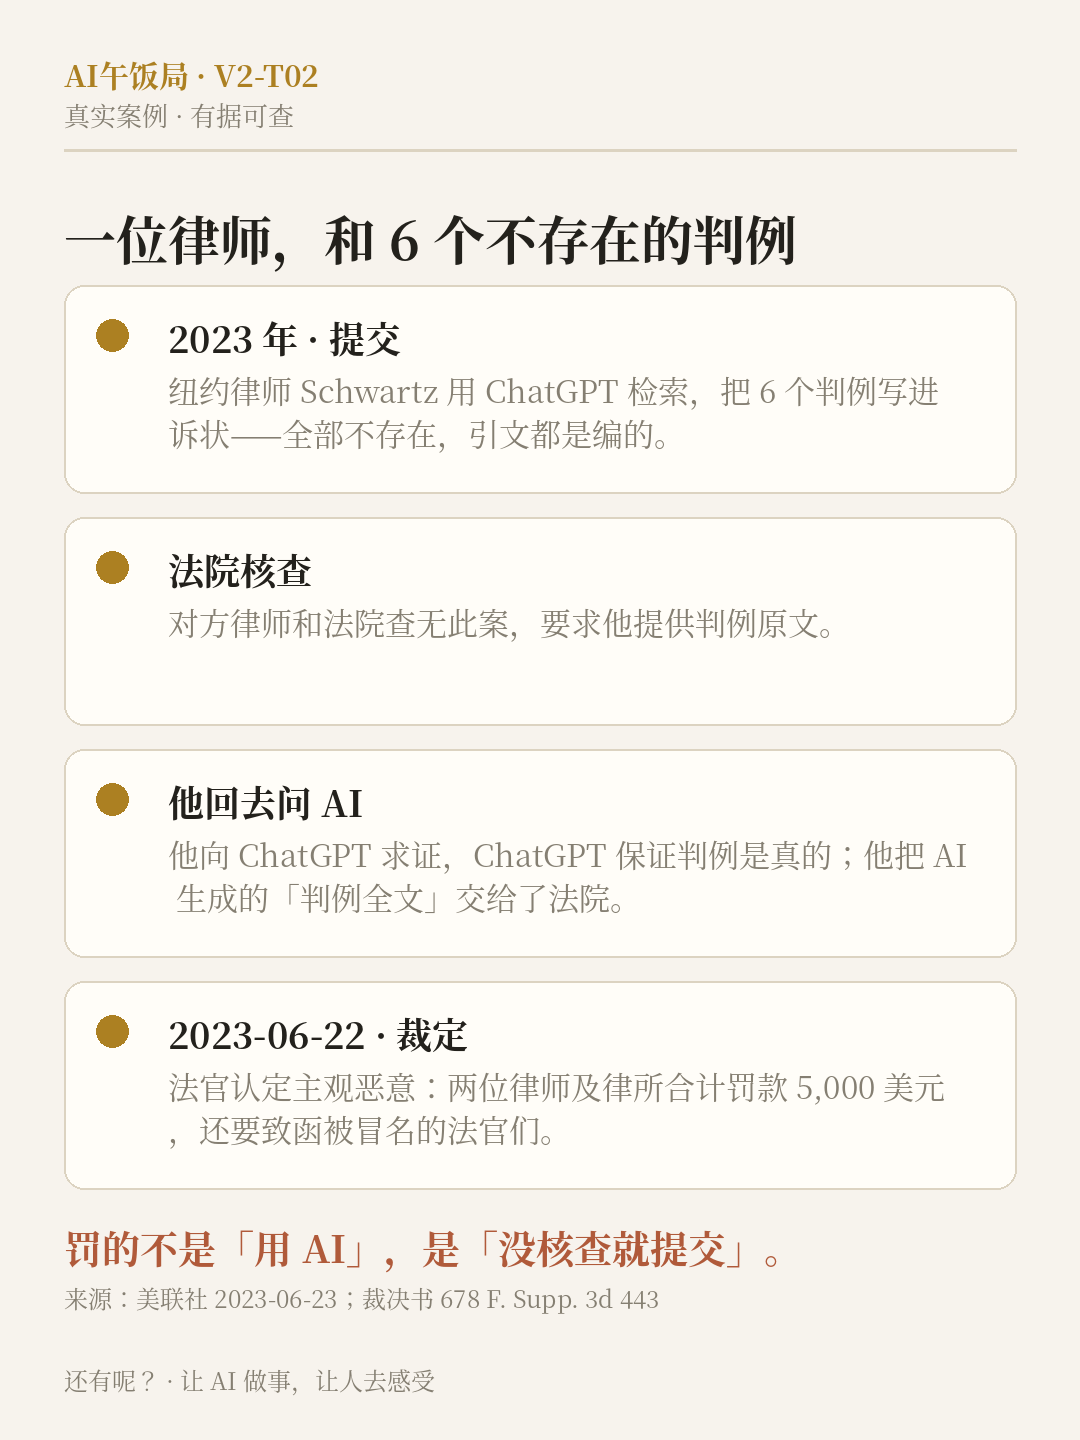
2023 年,美国纽约律师 Steven A. Schwartz 代理一起诉哥伦比亚航空(Avianca)的人身伤害案。他用 ChatGPT 做法律检索,在提交给纽约南区联邦法院的文书里引用了 6 个判例——全部不存在,连引文格式都是编造的。
接下来的发展更值得记住:对方律师和法院查不到这些案件、要求提供原文时,他又回去问 ChatGPT,ChatGPT 向他保证判例是真的。于是他把 AI 生成的「判例全文」交给了法院。
2023 年 6 月 22 日,法官 Castel 裁定:两位律师及律所构成主观恶意,合计罚款 5,000 美元,并须致函每一位被冒名「撰写」虚假判例的真实法官。
请注意法官罚的是什么:不是「使用 AI」,而是「未经核查就提交、被质疑后仍坚持」。问题从来不只在 AI 一边——它负责生成,人负责核查,这条分工线才是本案的教训。(来源 8)
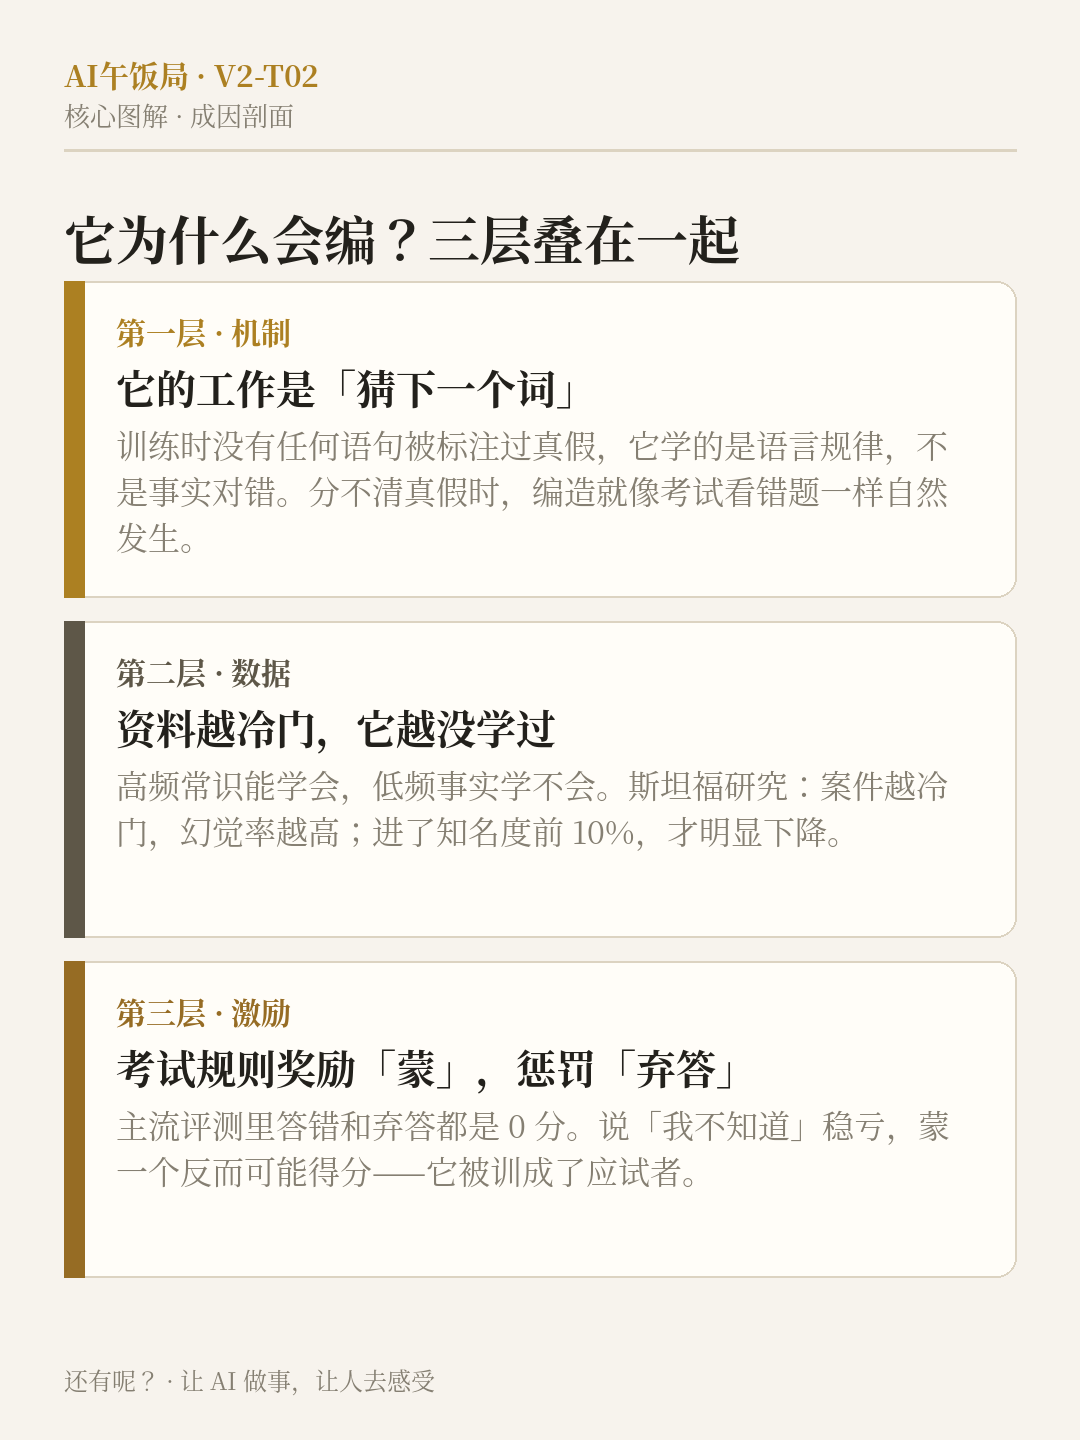
二、它为什么会编?拆开看,是三层
第一层:它的工作方式,本身就不分真假。 语言模型做的事是「预测下一个词」:它从海量文本里学到的是语言的统计规律,没有任何一条语句在训练时被标注过「真」或「假」。OpenAI 的研究者 Kalai 等人(2025)把这件事讲透了:如果一个模型分不清「有效陈述」和「错误陈述」,幻觉就会像分类器的误判一样自然发生。他们的论文里有个亲身例子:问一个先进的开源模型作者自己的生日,哪怕事先声明「知道才回答」,它三次给出了三个不同的错误日期。对生日这类没有规律可循的事实,理论证明:再好的模型也必然出错——一篇 STOC 2024 的论文标题就叫《校准良好的语言模型必然产生幻觉》。(来源 1、2、3)
第二层:资料越冷门,它越没学过。 高频规律(拼写、语法、常识)能靠规模学会;低频的任意事实不行。斯坦福的法律研究有个干净的佐证:案件知名度越低,模型的幻觉率越高;知名度进入前 10% 之后,幻觉率明显下降。说人话就是:你问得越偏门,它编得越多,还编得越自信。(来源 4)
第三层:考试规则奖励它「蒙」,惩罚它「弃答」。 绝大多数主流评测是二值计分:答对 1 分,答错和弃答都是 0 分。在这套规则里,「我不知道」是稳赔不赚的选项,蒙一个具体答案反而期望得分更高——模型于是被训练成了优秀的应试者:宁可编一个像样的答案,也不空着。Kalai 等人的结论是:要改的不是再加一个新评测,而是主流评测的计分规则本身——重罚自信的错误,给恰当的「不确定」留分。(来源 1、2)
三、一组数字,看清「愿不愿意说不知道」有多重要
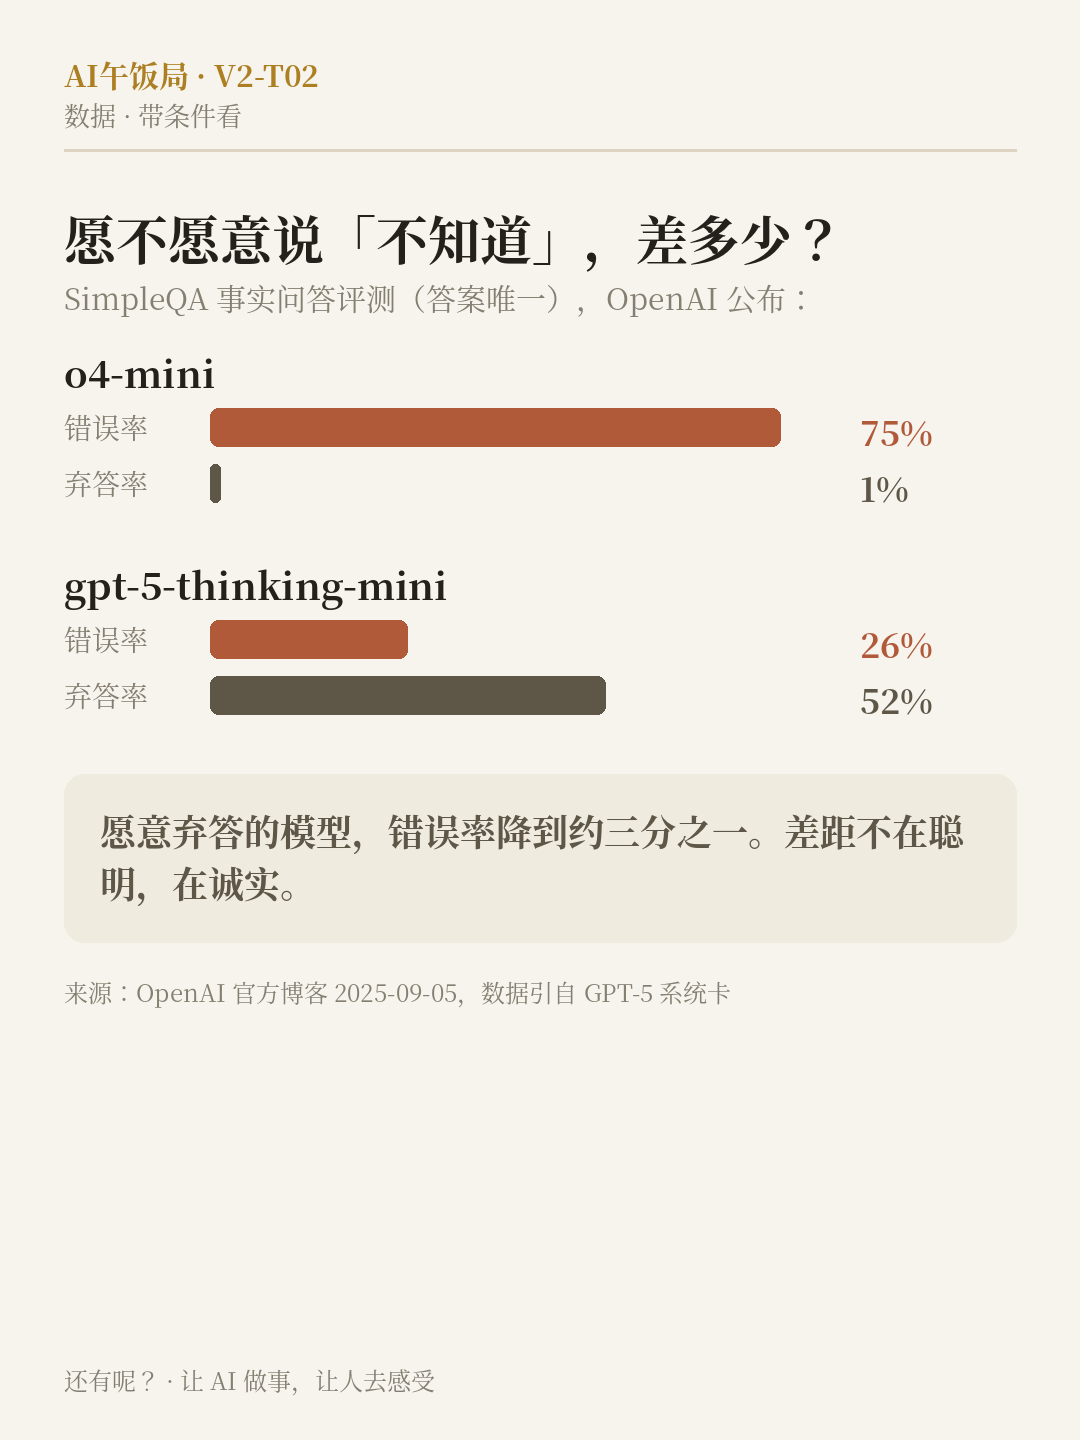
OpenAI 公布的 SimpleQA 评测(有唯一正确答案的事实问答,数据引自 GPT-5 系统卡):
- o4-mini:弃答率 1%,错误率 75%
- gpt-5-thinking-mini:弃答率 52%,错误率 26%
两个模型的差距与其说是「谁更聪明」,不如说是「谁更愿意承认不知道」。愿意弃答的那个,错误率直接降到约三分之一。(来源 2)
四、最反直觉的一点:它不知道自己正在编
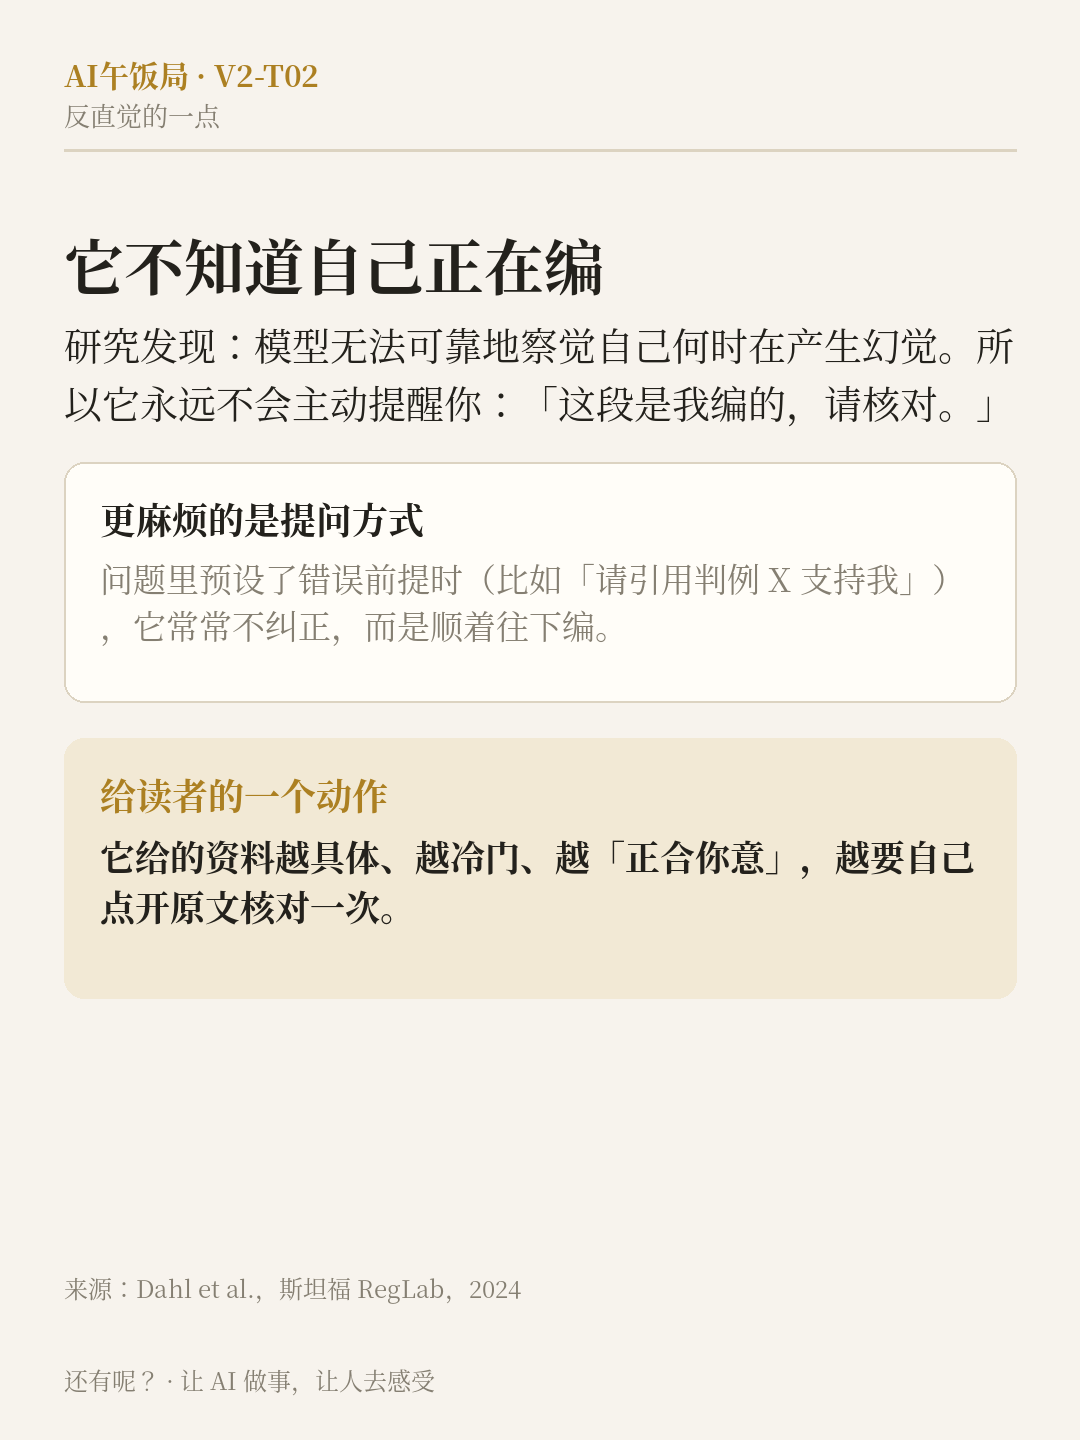
如果 AI 编完之后能小声提醒你「这段不确定」,问题还不算大。但研究发现,它做不到:模型无法可靠地察觉自己何时在产生幻觉(来源 4)。更麻烦的是,当你的问题本身预设了错误前提——比如「请引用判例 X 支持我的观点」——它经常不纠正,而是顺着错误前提继续往下编。
所以记住一个动作:AI 给的资料越具体、越冷门、越是「正合你意」,越要自己点开原文核对。
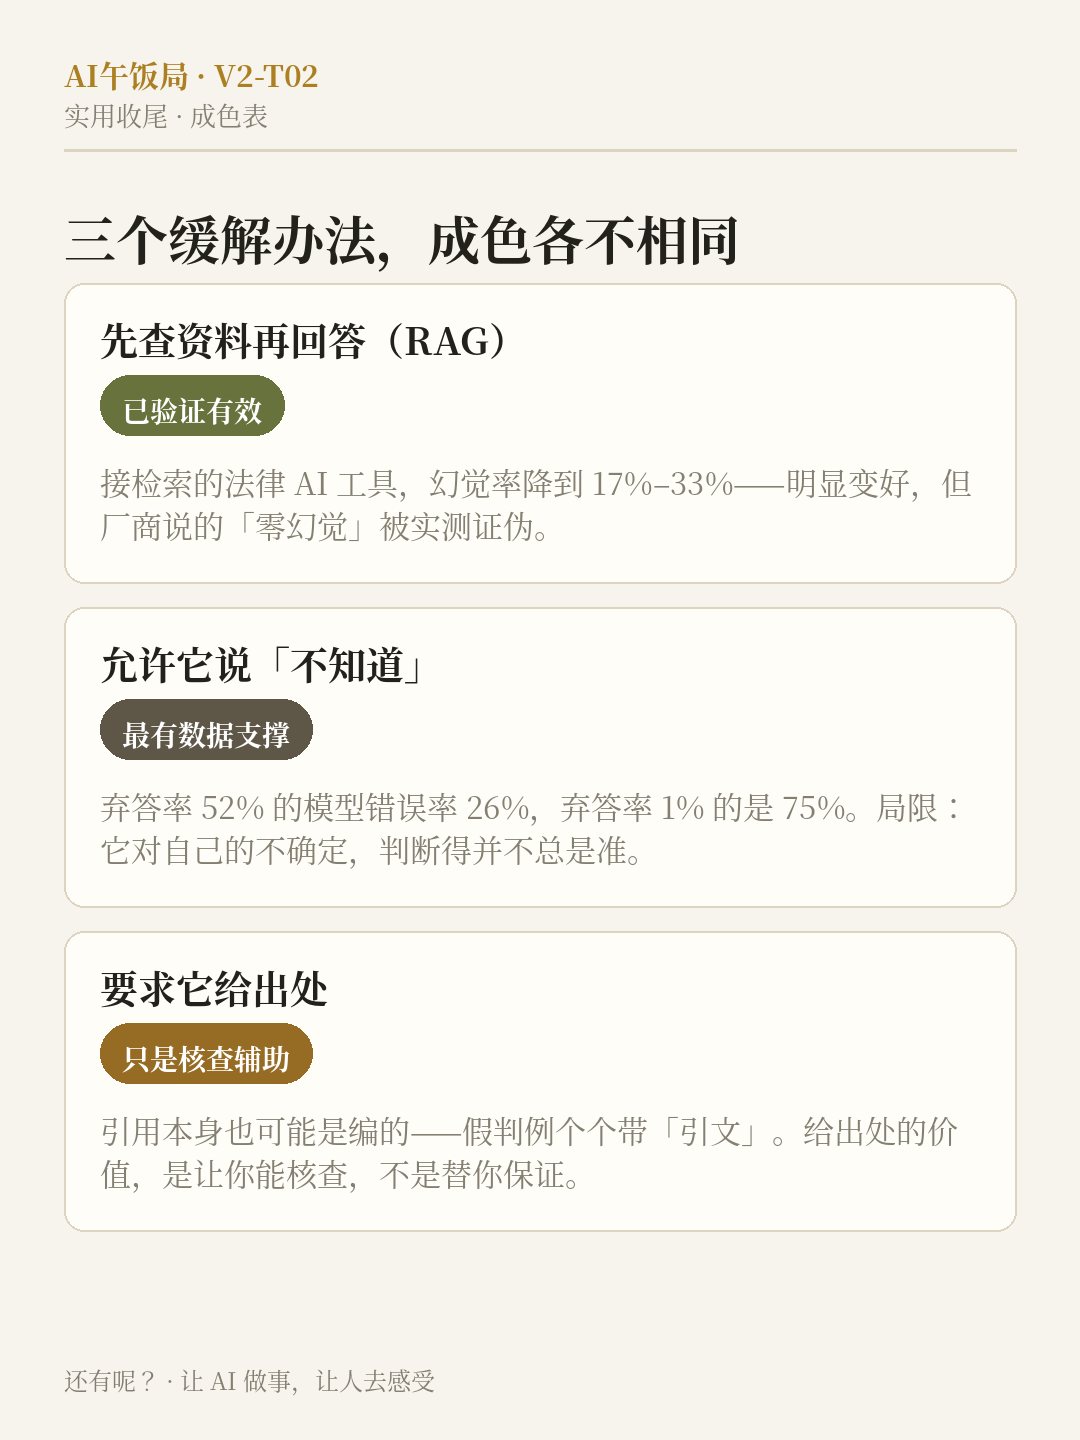
五、三个缓解办法,成色各不相同
办法一:先查资料再回答(检索增强,RAG)——已验证有效,但不是「归零」。 做法是回答前先从资料库检索原文,再让模型据此生成。斯坦福 2025 年预注册研究实测了主打「消除幻觉」的商用法律 AI 工具:接了检索之后,它们的幻觉率降到了 17%–33% 区间,明显低于通用模型,但远非为零——厂商的「零幻觉」宣传被实测证伪。(来源 5)
办法二:允许它说「我不知道」——目前最有数据支撑。 第三节那组对照就是证据:弃答能力直接决定错误率的量级。局限也要说清:它对自己「有多不确定」的判断并不总是准,所以这是方向,不是终点。(来源 2、7)
办法三:要求它给出处——只是核查辅助,不是可信保证。 引用本身也可能是编的:本期开场案里那些假判例,个个自带格式完整的「引文」。给出处的价值在于让你能核查,最终仍须人点开原文确认。(来源 5)
结尾
AI 编造资料,不是品行问题,是机制问题:一个按概率接龙的系统,被一套「鼓励猜测」的计分规则训练,又被我们拿去问最冷门的问题。看清这三层,你就知道该把核查的力气花在哪儿——不是每句都查,而是它说得最具体、最合你意、又最查不到出处的那些。
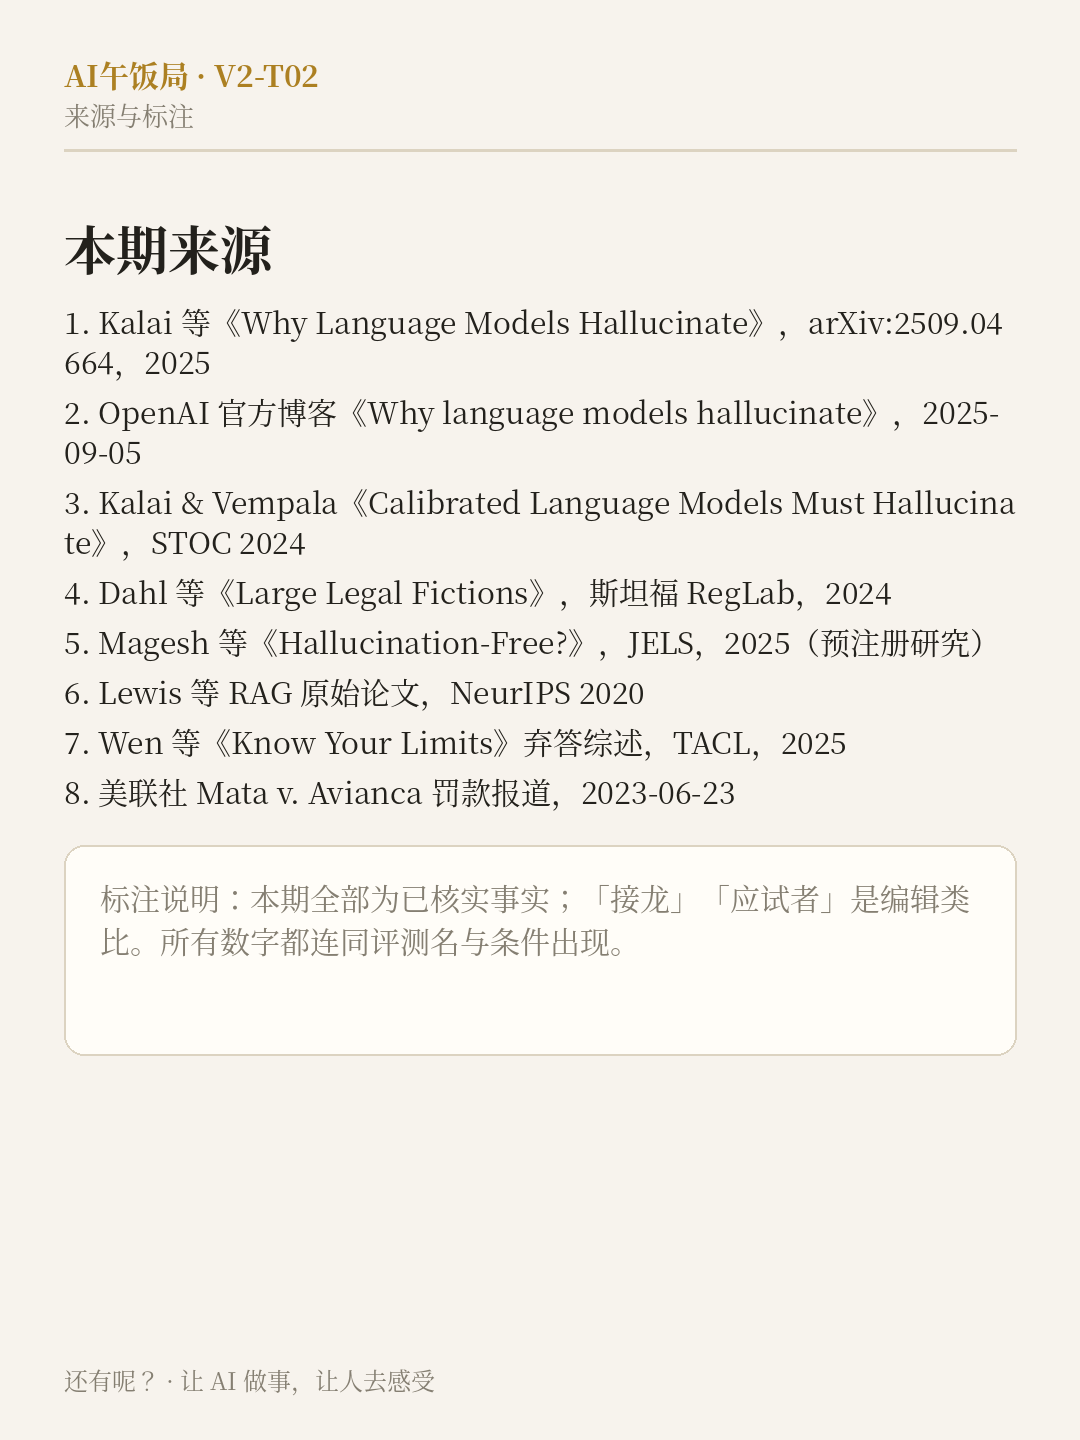
来源
- Kalai, Nachum, Vempala, Zhang《Why Language Models Hallucinate》,arXiv:2509.04664,2025-09-04 — https://arxiv.org/abs/2509.04664
- OpenAI 官方博客《Why language models hallucinate》,2025-09-05(SimpleQA 对照数据引自 GPT-5 系统卡)— https://openai.com/index/why-language-models-hallucinate/
- Kalai & Vempala《Calibrated Language Models Must Hallucinate》,ACM STOC 2024 — https://doi.org/10.1145/3618260.3649777
- Dahl, Magesh, Suzgun, Ho《Large Legal Fictions: Profiling Legal Hallucinations in Large Language Models》,斯坦福 RegLab,Journal of Legal Analysis,2024 — https://arxiv.org/abs/2401.01301
- Magesh et al.《Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools》,Journal of Empirical Legal Studies,2025(预注册研究)— https://arxiv.org/abs/2405.20362
- Lewis et al.《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》,NeurIPS 2020 — https://arxiv.org/abs/2005.11401
- Wen et al.《Know Your Limits: A Survey of Abstention in Large Language Models》,TACL,2025 — https://export.arxiv.org/abs/2407.18418v2
- 美联社《Lawyers Submitted Bogus Case Law Created by ChatGPT. A Judge Fined Them $5,000》,2023-06-23;制裁裁决书 678 F. Supp. 3d 443(Mata v. Avianca,纽约南区联邦法院)
*标注:文中「接龙」「应试者」为编辑类比,帮助理解机制,非来源原话。本期全部数字均连同评测名称与条件出现,未作脱离条件的引用。*