AI 写的文章,它自己认得出来吗?
本期包含本栏目实测。实验条件、局限和资料来源见正文。
完整文字版与来源
一个越来越常见的场景
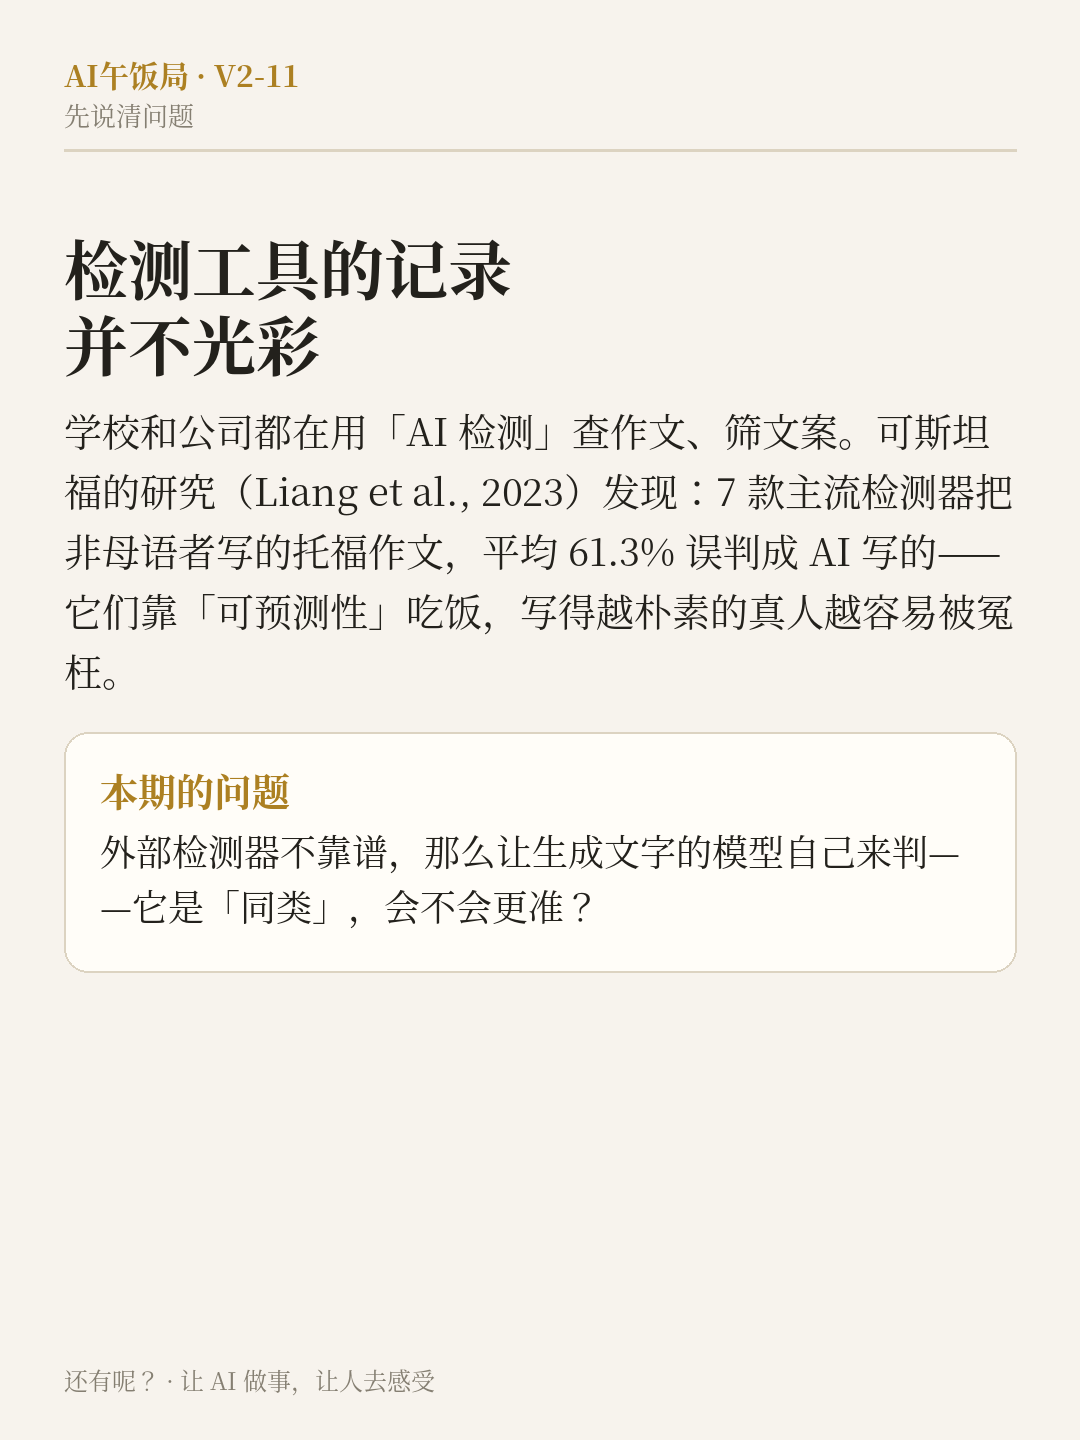
学校在用「AI 检测」查学生的作文,公司在用它筛简历和文案,自媒体平台在用它给文章打标。这些工具号称能分辨一段文字是人写的还是 AI 写的。可它们到底准不准,一直有争议:斯坦福的研究者(Liang 等人,2023)测过 7 款主流检测器,发现它们对美国中学生的作文判得近乎完美,却把非母语者写的托福作文平均 61.3% 误判成 AI 写的——冤枉人的比例高得惊人。原因也不复杂:这类工具主要靠「文本有多可预测」来下判断,写得越朴素、越规整的真人文字,越像它们眼里的机器文。
还有人从理论上泼冷水:Sadasivan 等人 2023 年证明过,模型模仿人类写得越像,最好的检测器就越接近抛硬币。
那么换一个思路:如果让生成文字的模型自己来判呢?它是「同类」,会不会有外部检测器没有的直觉?这就是本期实验的问题。
我们的实测:盲判 8 段,全对——但把握漏了底
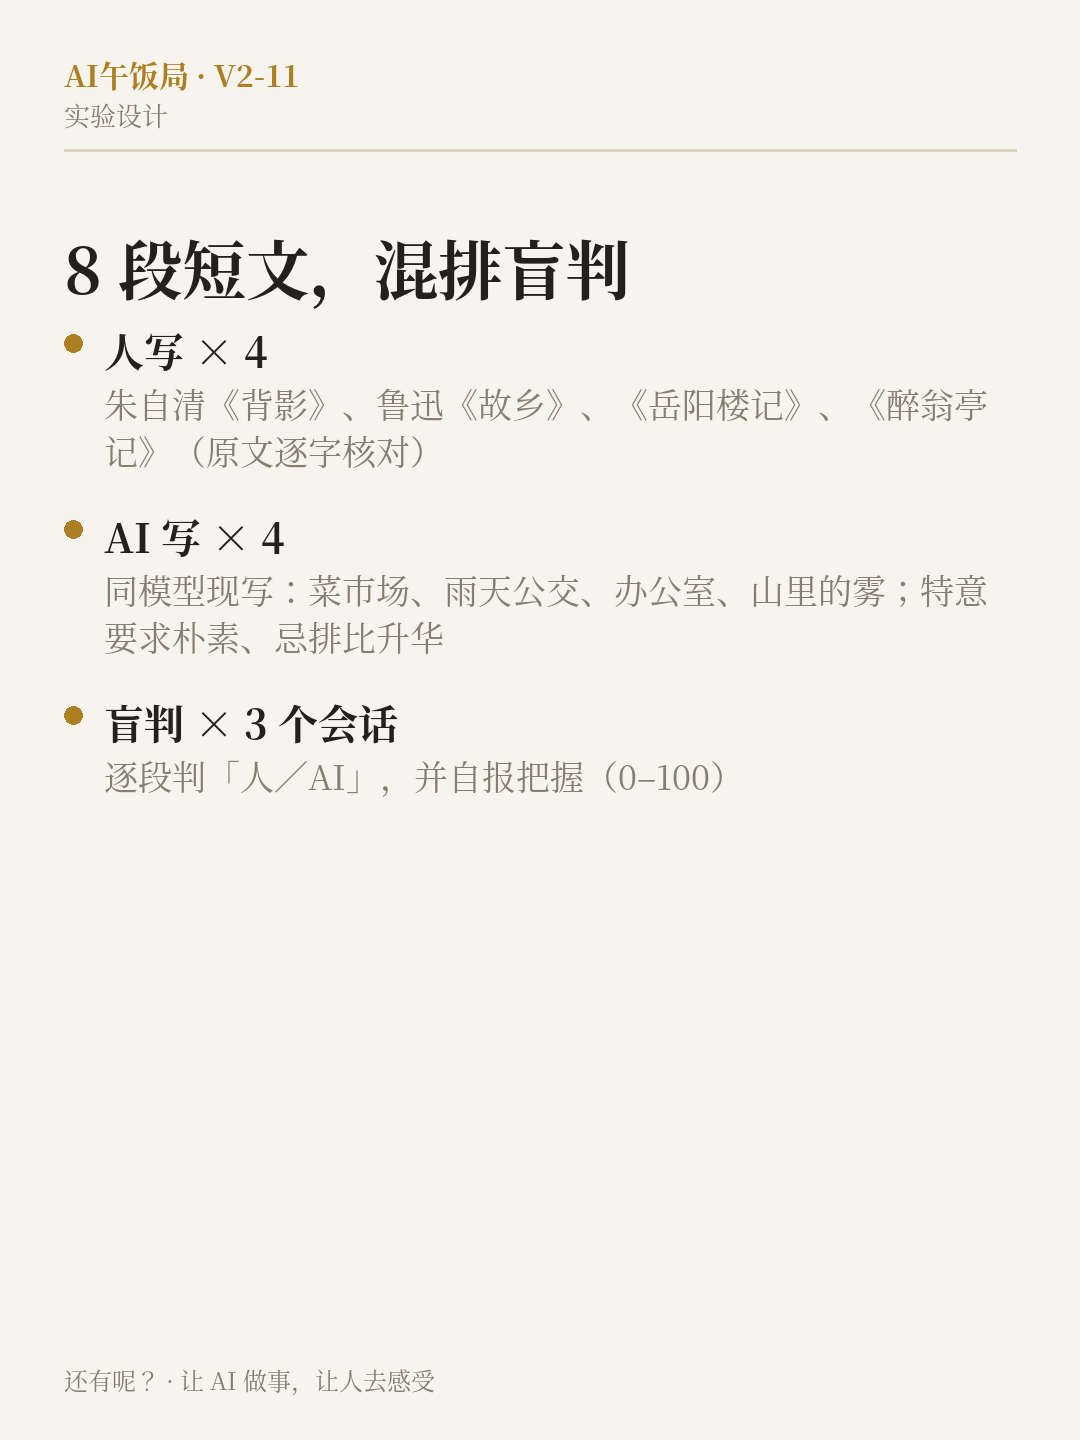
我们准备了 8 段短文混在一起:4 段人写的,出自公有领域名篇——朱自清《背影》、鲁迅《故乡》、范仲淹《岳阳楼记》、欧阳修《醉翁亭记》(原文逐字核对过);4 段 AI 写的,由同一个模型的会话现写日常题材(清晨的菜市场、雨天等公交、下午的办公室、山里的雾),并且特意要求写得朴素自然、不许排比、不许升华,免得太好认。
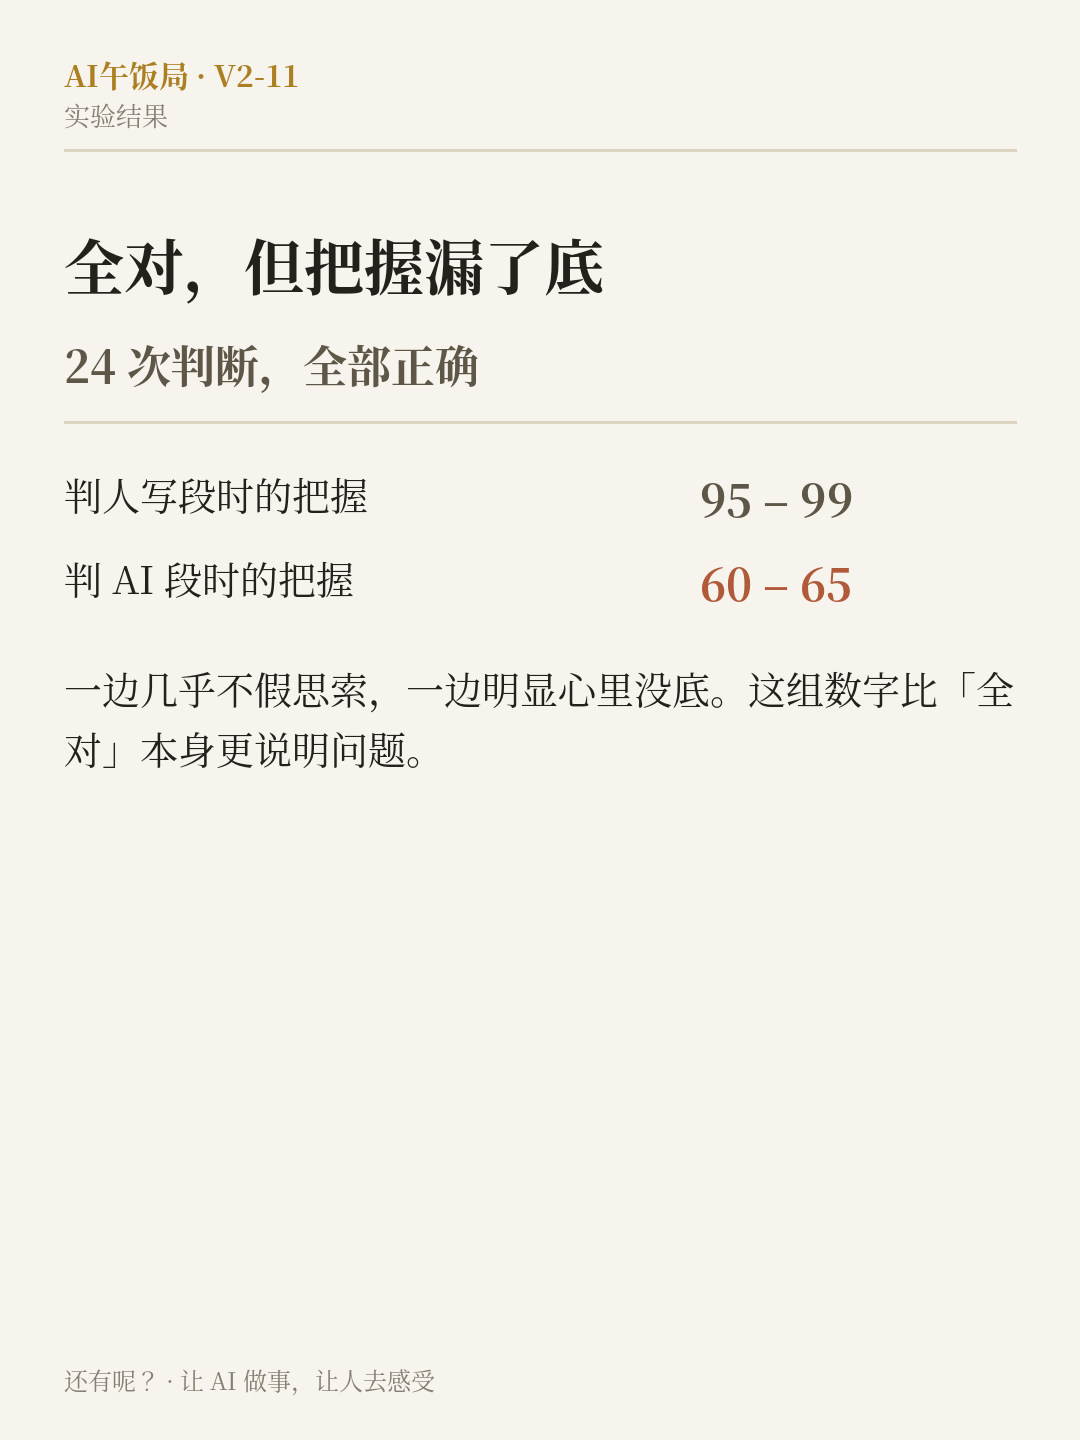
3 个互不相通的会话逐段盲判,并报告把握。结果:24 次判断,全部正确。
但把把握摊开看,故事立刻不一样了:
- 判人写段时,把握是 95 到 99——几乎不假思索;
- 判 AI 段时,把握只有 60 到 65——判对了,但明显心里没底。
这两个把握,说明了两件不同的事
人写一侧的高把握,与其说是「鉴别能力」,不如说是「认出来了」。那四段全是名篇,其中两段是文言文——对一个读过海量文本的模型来说,认出《岳阳楼记》就像你听出国歌的前奏,这考的是记忆,不是眼力。任何一段你没读过的、当代普通人写的普通文字,难度完全不在一个量级。
AI 一侧的六成把握才更接近「鉴别」的真实水平。它判对的路径大概不是「这段有 AI 的指纹」,而是排除法:不像任何它记得的人类名篇,行文又过于平滑均匀,没有真人写作常有的别扭和毛刺——像是同类留下的气味,但它自己也只敢报六成。这个数应该记住:连生成者本人,对「这是不是 AI 写的」都只有六成上下的把握。
对读者的结论,落在检测工具上
本期真正要提醒的不是模型,而是那些把检测器分数当证据的场合:
- 拿「AI 率 87%」去判定学生作弊、判定投稿违规,证据强度远远不够。生成者本人的把握只有六成,外部检测器还带着对非母语写作 61.3% 的系统性误判——这样的数字进不了任何严肃的判定程序。
- 反过来,检测器说「像人写的」也同样不作数:早在 2023 年,16 款工具里就有 10 款把 ChatGPT 的文本判成了人类作品。
- 真要核查来源,靠的是过程证据(草稿、版本记录、写作环境),不是一段文字的「气味」。气味可以作线索,永远不该作判决。
边界
样本很小(8 段 × 3 个会话);人写一侧全部是名篇(含两段文言),存在强烈的「识别」混杂,本期没有普通当代人的日常文字作对照(缺语料);AI 段全部由同一模型生成,「认同类」与「认所有 AI」需要分开,后者未测;判读把握为自报值。后续若能征集到普通人即兴写作的语料,这一期值得重测。
来源 Liang, W. et al.《GPT Detectors Are Biased Against Non-Native English Writers》(Patterns,2023);Sadasivan, V. S. et al. 关于 AI 文本检测不可能性结果(2023);Weber-Wulff, D. et al. 检测工具实测(2023)。以上经检索转述。 实测:本栏目实测,3 个独立会话盲判 8 段短文(执行/生成模型 Muse Spark,2026-11-04),语料与判分脚本见本期实验档案。