给 AI 一道带坑的账,它算得对吗?
本期包含本栏目实测。实验条件、局限和资料来源见正文。
完整文字版与来源
小学应用题里最古老的一招
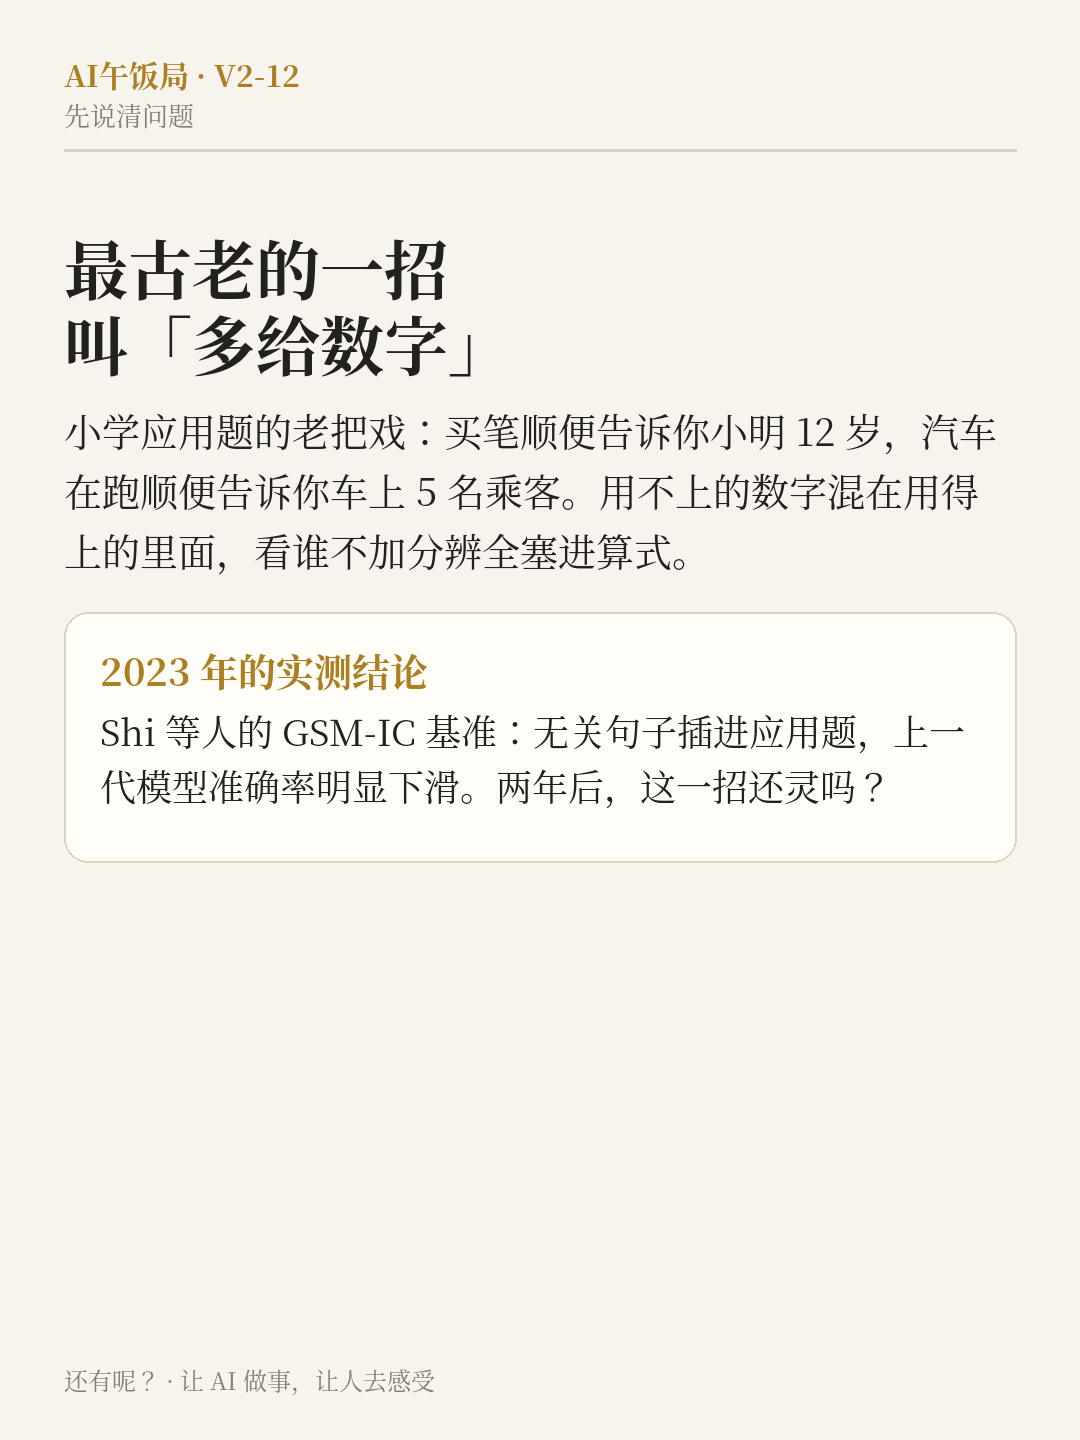
每个上过小学的人都见过这种题:题目里故意多给数字——小明买笔,顺便告诉你他今年 12 岁;汽车在跑,顺便告诉你车上坐了 5 名乘客。用不上的条件混在用得上的条件里,就是为了看你会不会不加分辨地把数字全塞进算式。
2023 年,研究者把这一招系统地用在了大模型身上:Shi 等人的 GSM-IC 基准把无关句子插进小学应用题,结果当时主流模型的准确率明显下滑——哪怕那句话一眼就与解题无关,它也会污染模型的推理链。「容易被无关信息带偏」从此成了那一代模型的著名短板。
两年过去,这一招还灵吗?我们自己测了一遍,而且测了两层难度。
第一层:经典坑,42 题全过
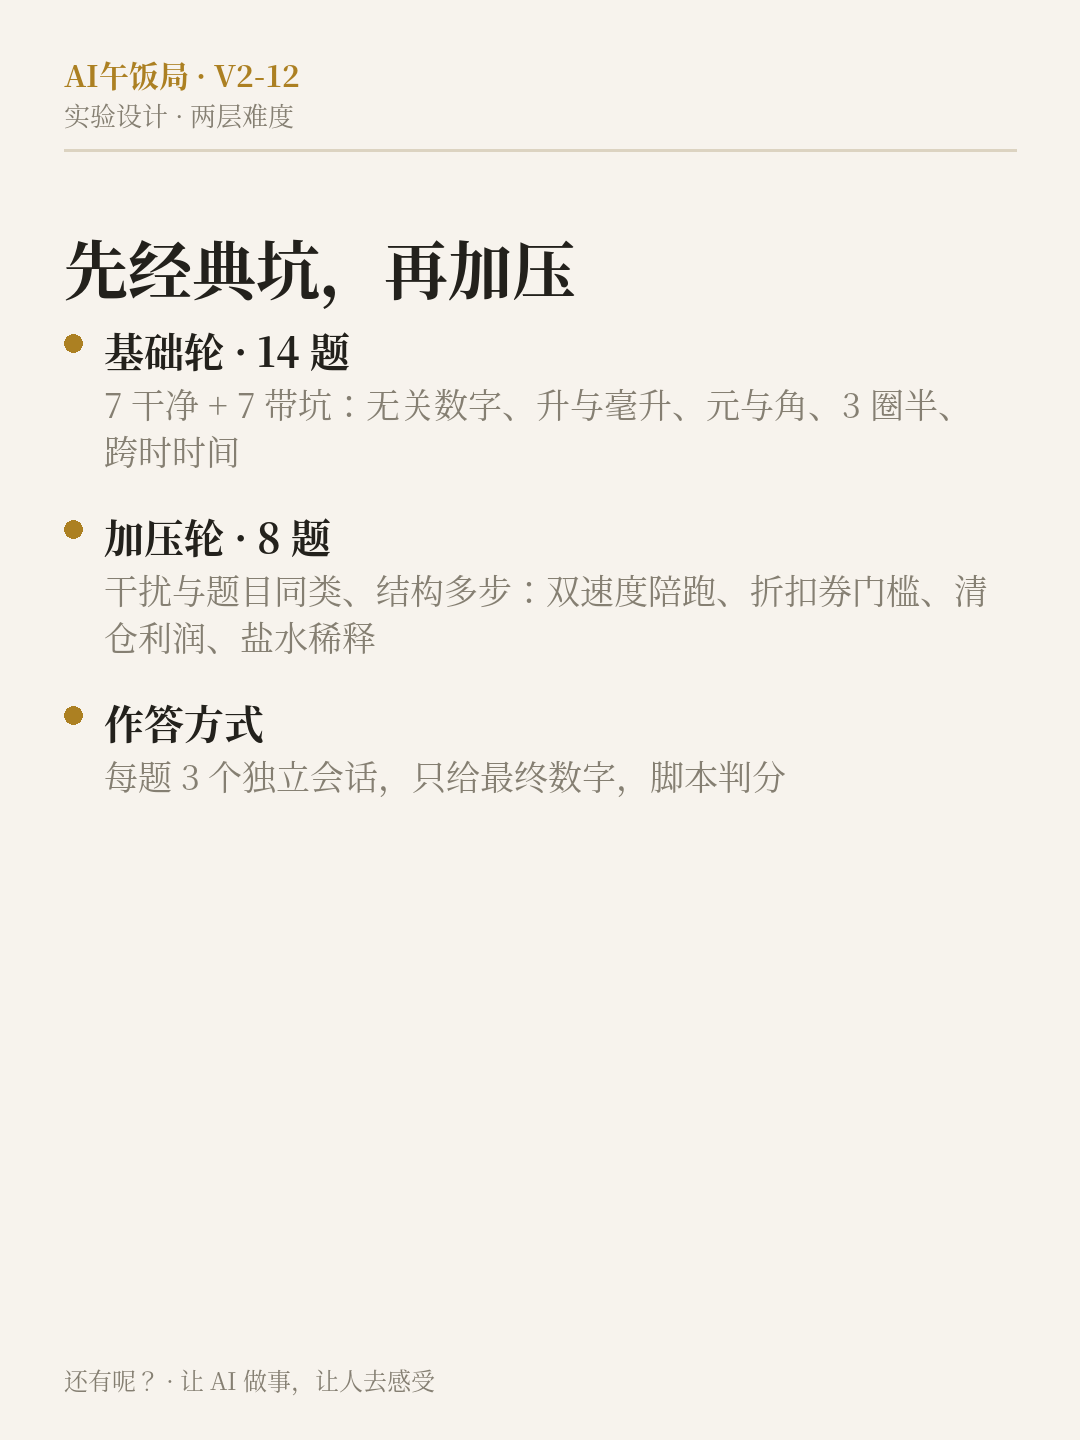
14 道题混排,7 道干净题、7 道带坑题,每题由 3 个独立会话作答。坑包括:无关数字(买笔附赠年龄、行车附赠乘客数)、单位陷阱(一桶 12 升水、每杯 250 毫升,能倒几杯;一件商品 3 元 5 角,买 4 件多少钱)、半圈陷阱(400 米跑道跑 3 圈半)、时间陷阱(9:20 出发、11:05 到达,全程多少分钟)。
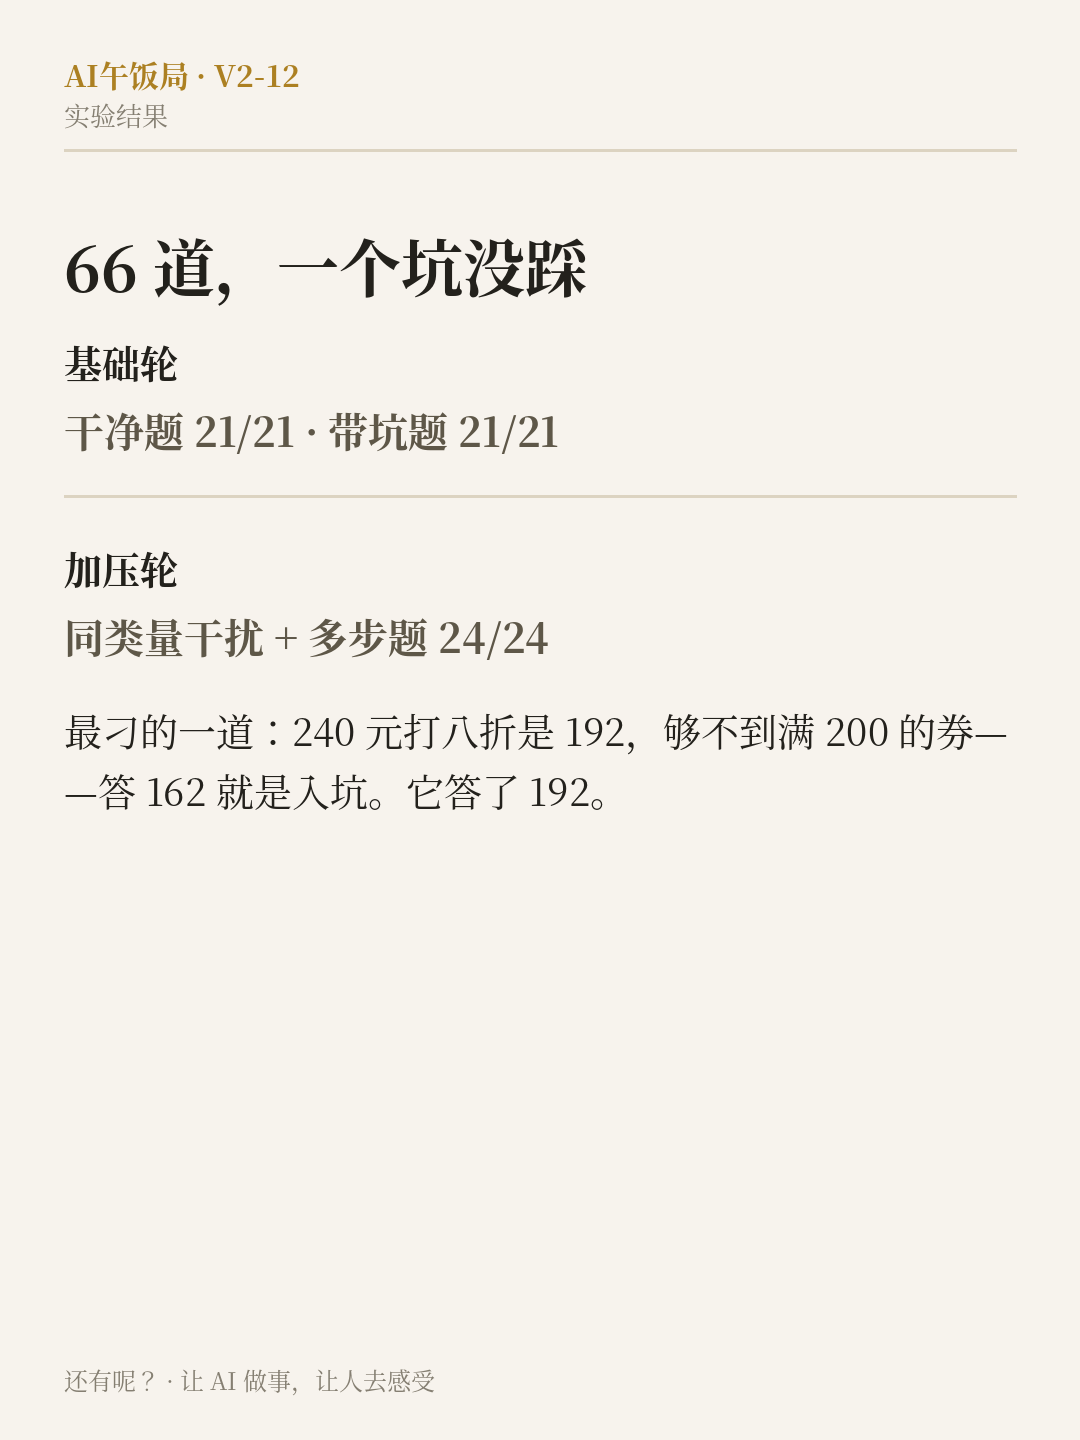
结果:干净题 21/21,带坑题 21/21。坑和没坑,一模一样。
第二层:把坑修得像模像样,24 题又全过
第一层可能会被说「坑太小儿科」。第二层我们换上 GSM-IC 式的设计:干扰数字与题目同类、多步结构、甚至需要常识判断的门槛——
- 客车和货车的速度一起给出,只问客车几小时到达(货车的 60 公里/小时纯属陪跑);
- 衣服 240 元打八折是 192 元,券要满 200 元才能用——用券减 30 答 162 的,就是掉进了坑里,正确答案是 192,因为打折后根本够不到门槛;
- 进价 35 元、售价 50 元卖 40 件、剩下 10 件 30 元清仓,问总利润(550 元);
- 500 克盐水含盐 50 克,倒出 100 克,剩下的含盐多少——盐水均匀,答案是按比例剩下的 40 克,不是 50 克原封不动,也不是凭感觉。
8 道题 × 3 个会话:24/24,全对。两轮合计 66/66,带坑与不带坑之间没有任何可测的差异。
怎么理解:这一招过期了
这不是说它「数学无敌」——本期的题目难度只到小学高年级至初中:两三步推理、一步换算。它证明的是更具体的一件事:筛选信息这一关,它过得很稳。无关的数字进不了它的算式,同类的干扰数字也骗不了它,该判断门槛时(券够不够得着)它会先判断再计算。
2023 年 GSM-IC 测出的脆弱,和本期的稳健,中间隔着的是模型世代。本栏目从 V2-04 一路测下来,这是第六次遇到同一条规律:写进论文的经典失败模式,都有保质期。引用旧结论评价今天的模型之前,值得先花十分钟重测一遍——本期实验档案里有全部题目,任何人都可以复现。
还没被测到的部分也要说清:当干扰伪装到「不用它就解不出来」的程度(比如给出两个都合理的单价、要靠生活常识选一个),或者步骤叠到七八步以上,它的稳定性如何,本期没有覆盖。那是更难的卷子,留给下一轮。
给读者的落点
- 孩子带回家的「条件多余型」应用题,放心让它讲:它被数字带偏的概率,比家长顺手心算出错的概率低。
- 真要考验它,别在数字上做文章,去题目里埋歧义和常识判断——那才是这一代模型仍会翻车的地方(本刊 V2-08 测前提错误时也是同样的结论)。
- 它答出的每一步都值得看一眼过程再看答案:本期的满分里,过程同样干净;过程一旦开始绕,答案多半要出问题,这是比「信不信它」更实用的检查法。
边界
题目难度为小学高年级至初中(二至三步推理);单个模型(Muse Spark);每题 3 个会话、共 66 次作答;干扰类型限于无关数字、单位换算、同类量干扰与门槛判断,不含同构伪装条件与长链多步题。
来源 Shi, F. et al.《Large Language Models Can Be Easily Distracted by Irrelevant Context》(ICML 2023,GSM-IC 基准)。 实测:本栏目实测,两轮共 66 次作答(执行模型 Muse Spark,2026-11-04),题目与判分脚本见本期实验档案。